【Pi Coding Agent】我的个性化配置v2
第一期的文章:【Pi Coding Agent】我的个性化配置,已经基本介绍了我的配置环境,现在更新了很多,于是写篇文章继续记录一下,稍微做一下核心要点总结,很多 bug 修复就不要记录了。
Pi Coding Agent 使用统计
Pi Coding Agent 现在已经是主力 agent 了,自己设计的插件自己使用,然后再迭代,确实挺爽,也属于成果驱动了吧,多巴胺分泌满满。统计一下使用的数据,看看具体的使用情况,包括本地电脑和 vps 上的使用数据,由 Pi Coding Agent + glm5.3flash low 统计,仅供参考,不一定完全准确。统计时间:
- 本地(Mac):2026-09-01 → 2026-11-10
- VPS:2026-10-16 → 2026-11-10
- 对话数:1916个
- 用户消息:6833条
- 消息总数:约17.7万条
- token:约41.9亿
- 模型使用统计:
- glm-5.3-flash(1111次)
- deepseek-v4.1-flash(595次)
- kimi-k3(330次)
- gpt-6.1-sol(16次)
远程 vps
介绍一下我的 Pi Coding Agent 是怎么用在 vps 上面的。
背景
我经常需要移动电脑,并且全部身家就只有一部 mba,同时很多时候我需要后台运行 Pi Coding Agent 在我盖上电脑屏幕的时候,于是我经常使用这个组合:
- 手机开着热点给电脑连接,保证网络
- Amphetamine 软件用于动态控制电脑唤醒的时间,比如这 4 小时内电脑都在唤醒状态
- 使用 bash 命令
pmset displaysleepnow关闭屏幕,然后盖上电脑,但是电脑在运行
这一套不是不能跑,是能跑,但是费电,加上我的 mba 电池好像不太行了,我经常需要用充电宝给电脑充电,而且 Amphetamine 有时候有个 bug,开启了没生效,盖上电脑就暂停运行了,等于白弄了。总体上这一套属于是能运行,但是体验并不是很好。
其实上整体的需求是电脑没开启的时候,也能运行 Pi Coding Agent,那么自然就需要另外一台机器跑,比如放在家里面的手机、电脑、电视盒子,vps等。
因为我还有一个月的 gcp 赠金,于是我想用 vps 看看,后续过期了还得看看怎么搞,不太想花钱哈哈哈,总之先把这一套跑起来。
Pi Coding Agent 放到 vps
有三个方案:
- 使用 pi-ssh-remote 这种插件,本地运行 agent,文件操作和命令执行在 vps 上执行。这种不符合我的情况,因为还是会得保持电脑在运行状态。
- 把 Pi Coding Agent 跑在 vps,我目前采用的是这个方案。
- Pi Coding Agent 的 rpc 模式,或者新版本的 Pi Durable,感觉对我的代码改动太大了,暂时不考虑。
所以我需要做的就是:
- 把所有插件、配置放到 vps
- kitty + tmux 这一套兼容跑在 vps
所有插件、配置放到 vps
我让 ai 根据我现有的环境,写一个脚本,然后在全新的 debian 上面,执行这个脚本,就能够
- git clone 所有我自己的开发插件到本地,然后 pi install,因为我还得修改这些插件,所以只能拉下来。
- pi install 别人的插件。
- 将我自定义的 slash command、prompt、settings.json 等 Pi Coding Agent 配置迁移到 vps。
- 安装上常用的开发环境,比如 curl、zsh、nodejs 等等。
配置是链接的方案,后续配置就跟着仓库走了,这样修改后提交,后续可以快速迁移到新的机器。
LLM 网关我之前是本地部署 octopus,现在部署在 Northflank 平台,用的 Prisma PG数据库,两个都是免费的。缺点就是像黑与白这种限制 ip 的公益站用不了,可以在 vps 再跑一个或者是直接写到配置里面吧,到时候看看怎么搞,目前还没有用到黑与白的模型。
kitty + tmux 兼容 vps
这个肯定是得修改代码,跑不掉,好在修改的不多,因为之前是 tmux 跑在本地电脑上面,然后通过本地 socket 跟 kitty 建立连接,现在是 tmux 跑在 vps 上面,通过远程 socket 跟 kitty 建立连接,大差不差。
查看项目代码也是沿用了 vscode,毕竟 vscode remote 模式可以快速连接到 vps,然后直接查看和操作 vps 上的项目。所以现在如果 tmux 跑在本地,按ctrl+b+v,直接打开本地 vscode 查看项目,如果是跑在vps,也是可以按同样的快捷键,只不过是打开的是 vscode remote,需要稍微等一等初始化。
ssh 连接,我之前用的是 mosh,后来发现这个项目很久没更新了,跟现代的终端有点冲突,于是我换成了,trzsz-ssh 和 tsshd,用的 kcp 协议,效果其实跟 mosh 差别,主要用处是:断网后能自动恢复连接,所以盖上电脑,断网了,然后回到家,重新打开电脑,它会自己连接上,稍微等一会,所有东西都在,一样的排版,好像没有变过一样,这样体验会好很多。
所以现在的情况就变成:
- 如果在本地电脑上跑 Pi Coding Agent,那么直接在kitty tab上输入 spi (alias 命令)就行了。
- 如果在 vps 上跑,那么得先输入tssh-vps(alias 命令),然后再 spi(alias 命令)就行了。
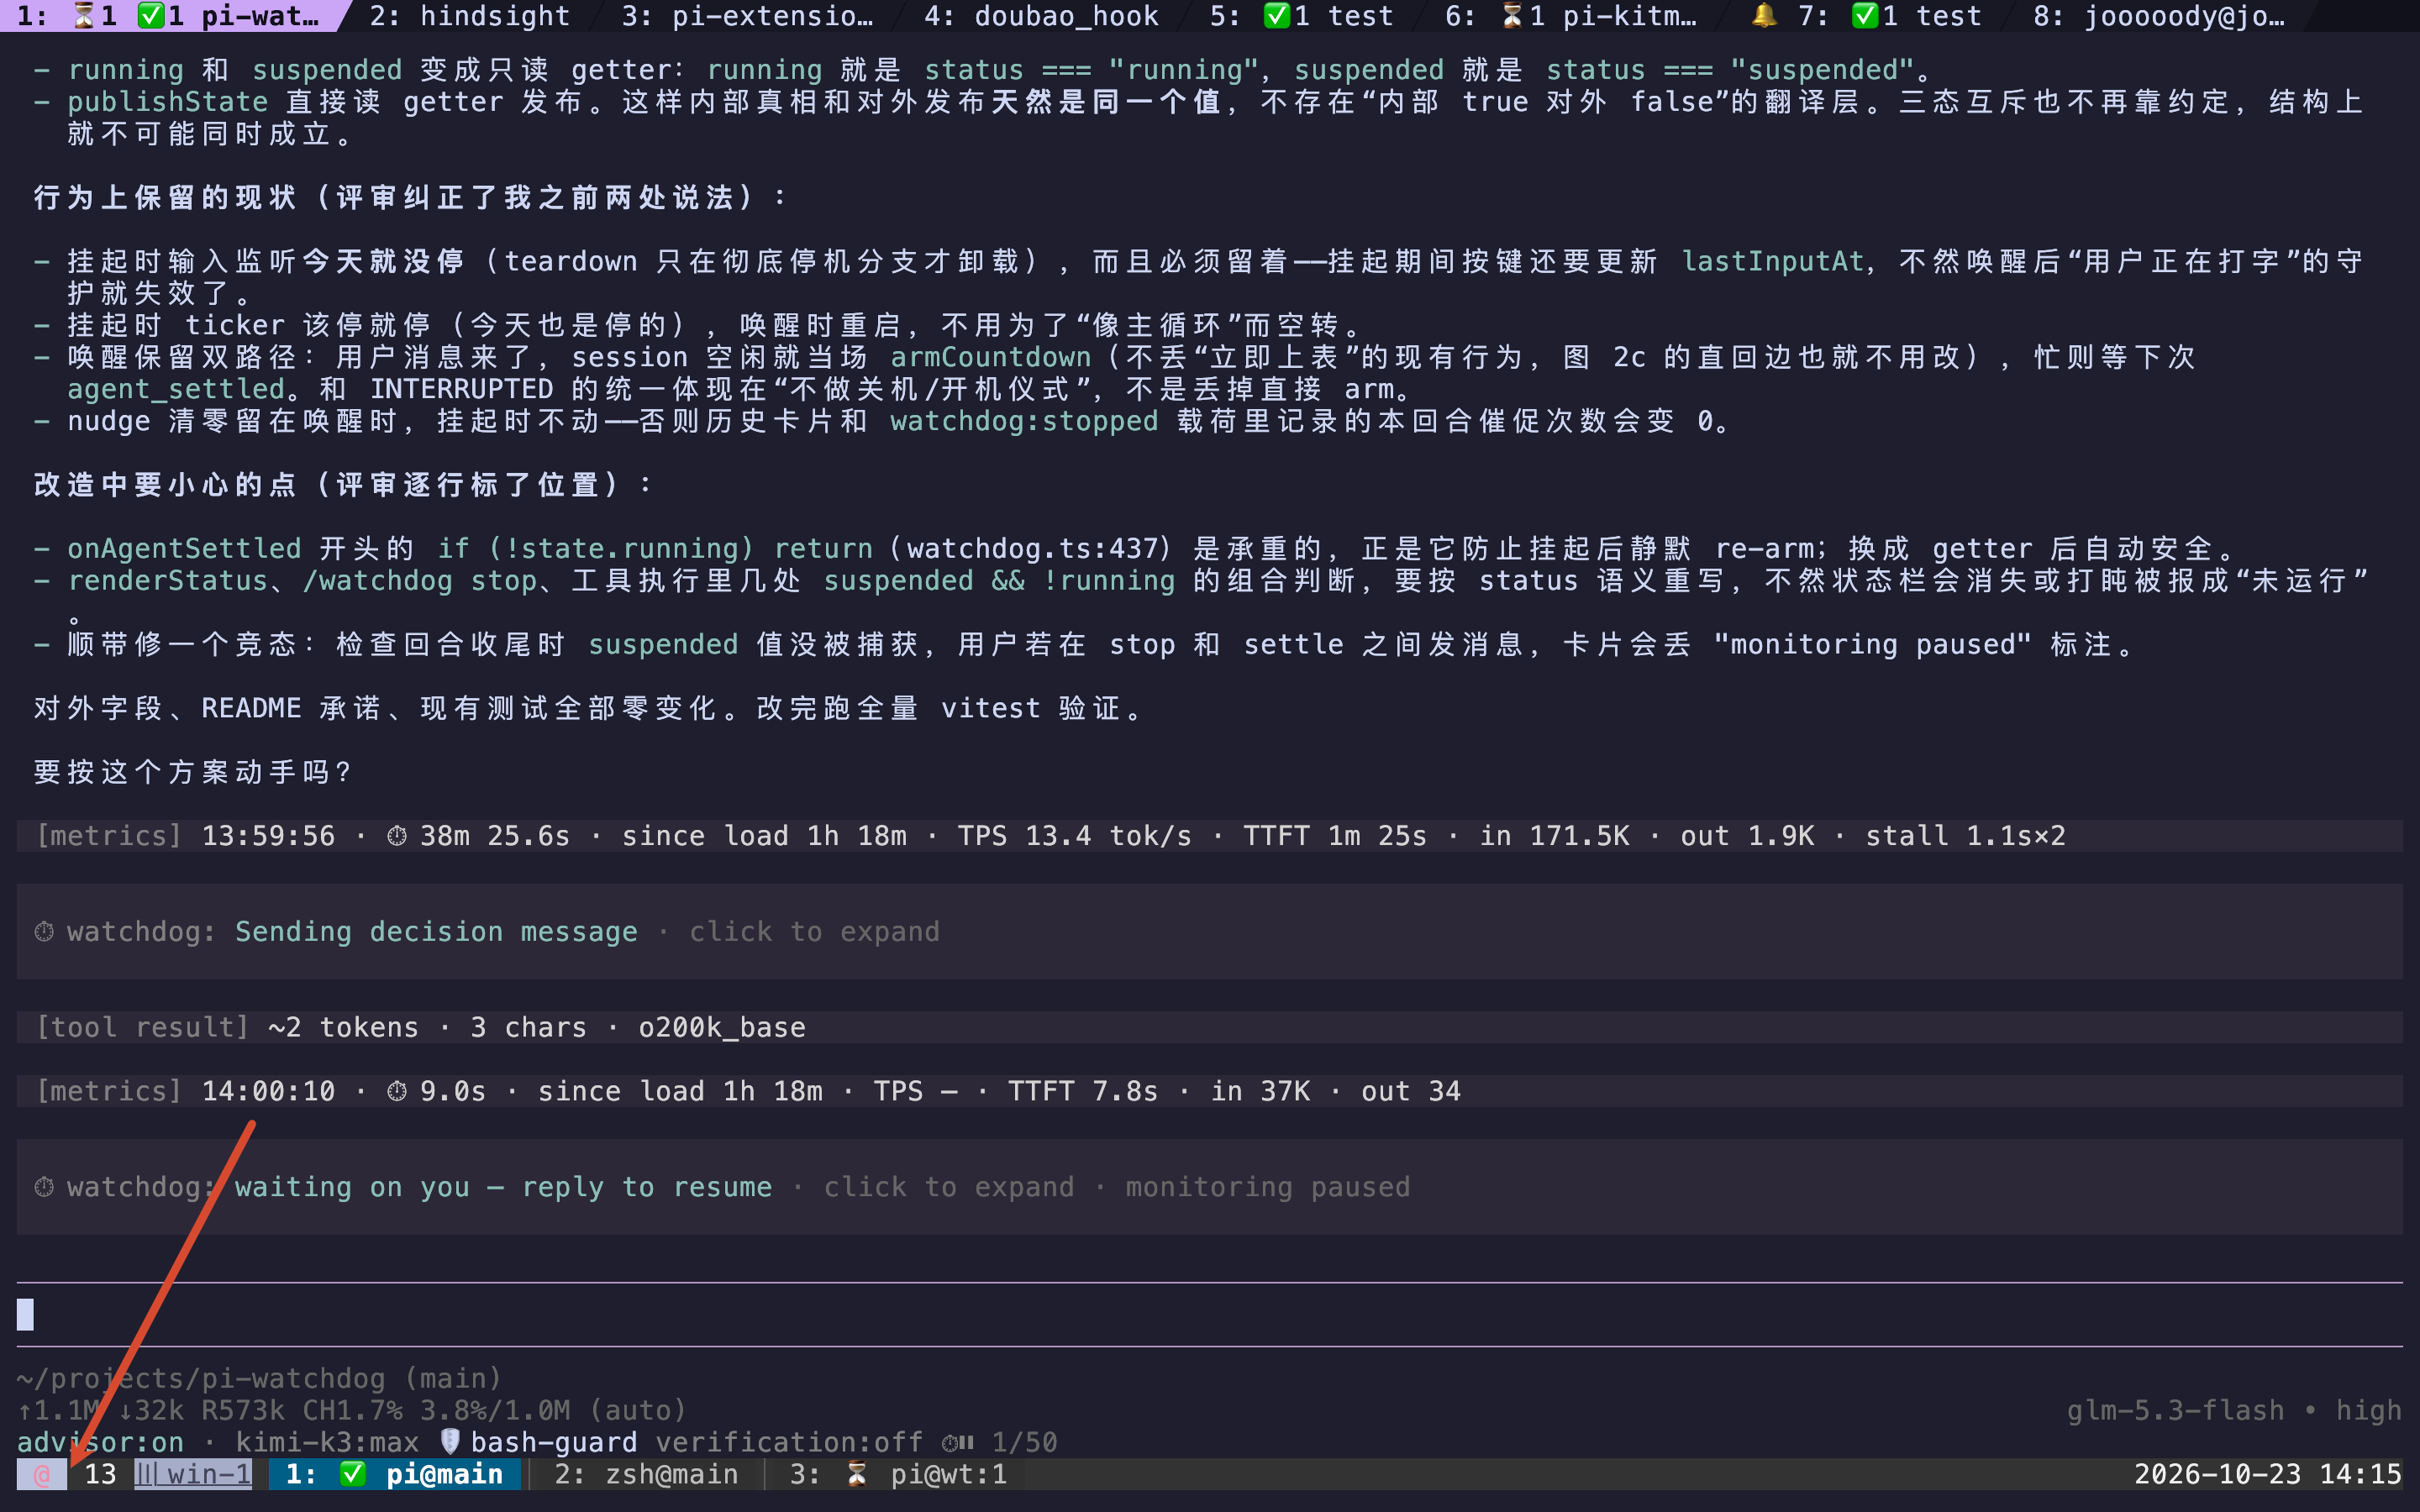
上图是本地电脑的 kitty,然后这个 tab 是连接在 vps,看左下角的 debian 图标就知道了,然后 tmux 是跑在 vps 上面的,有三个 tab,其中第一个和第三个代表跑了两个 Pi Coding Agent,分别是 main 分支 和 名字为 1 的 worktree 分支。
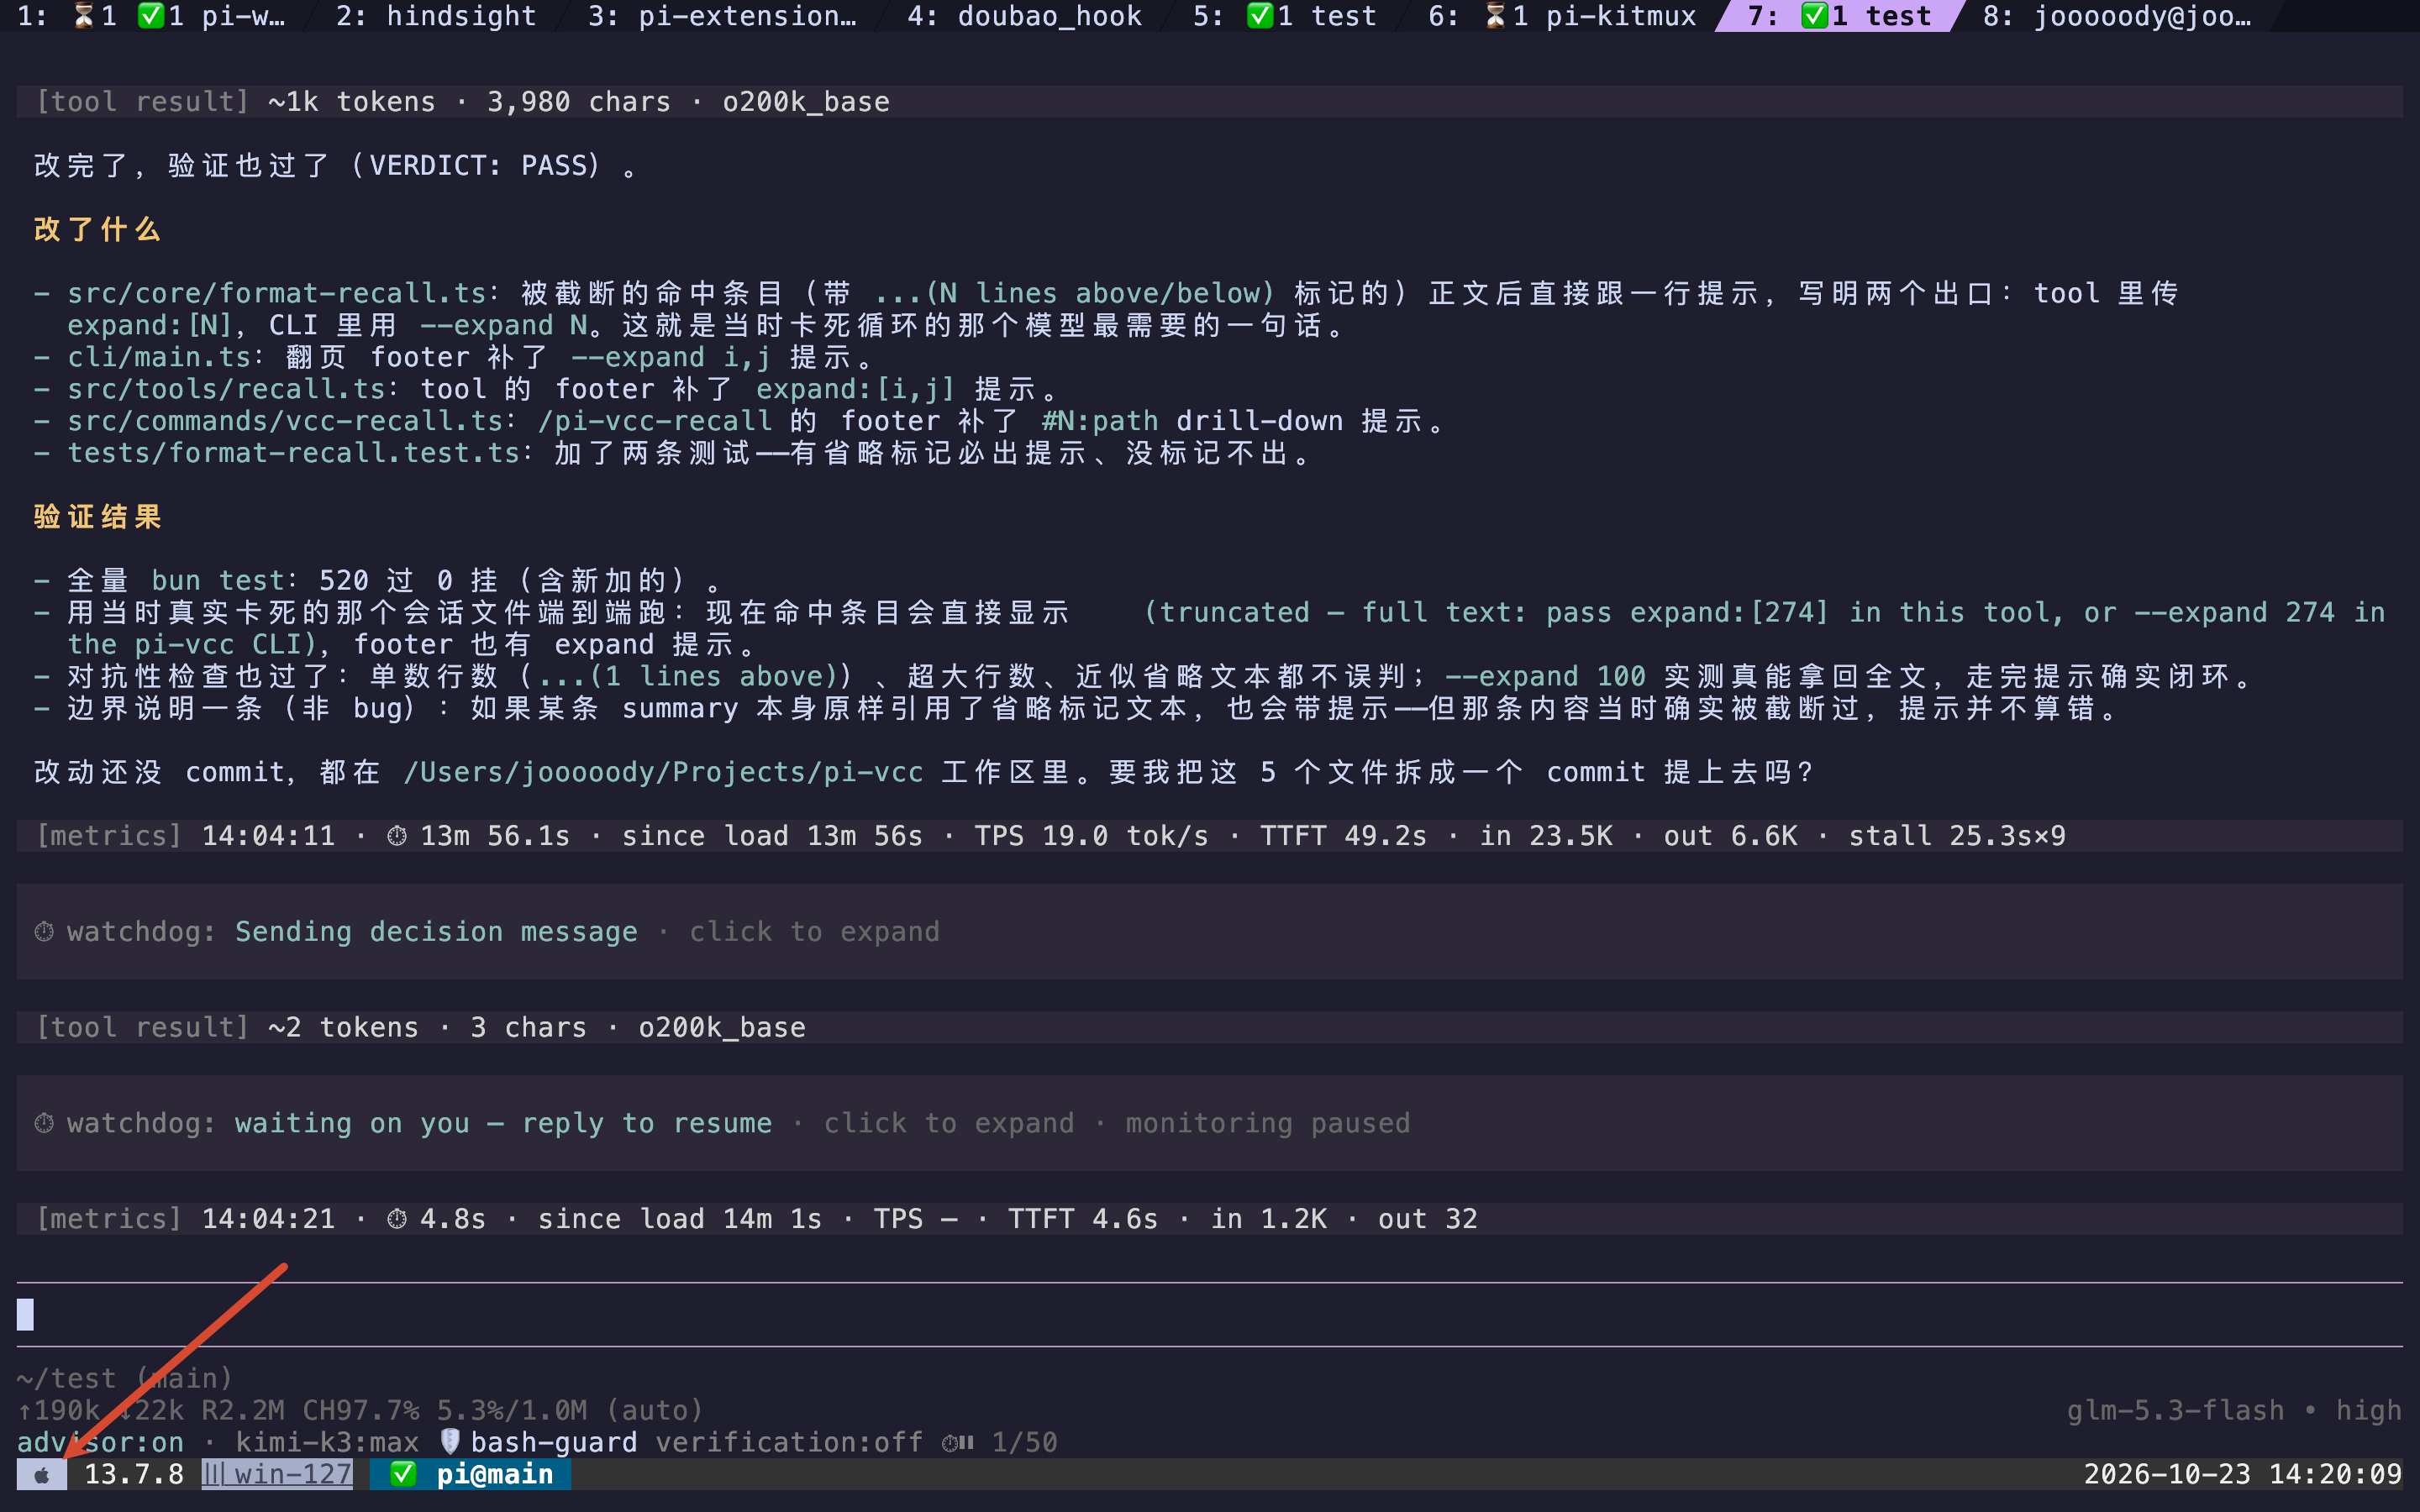
这个则是相同的 kitty 进程,不同的 tab,这个 tab 是跑在本地 mac 上,目前只跑了一个 Pi Coding Agent。
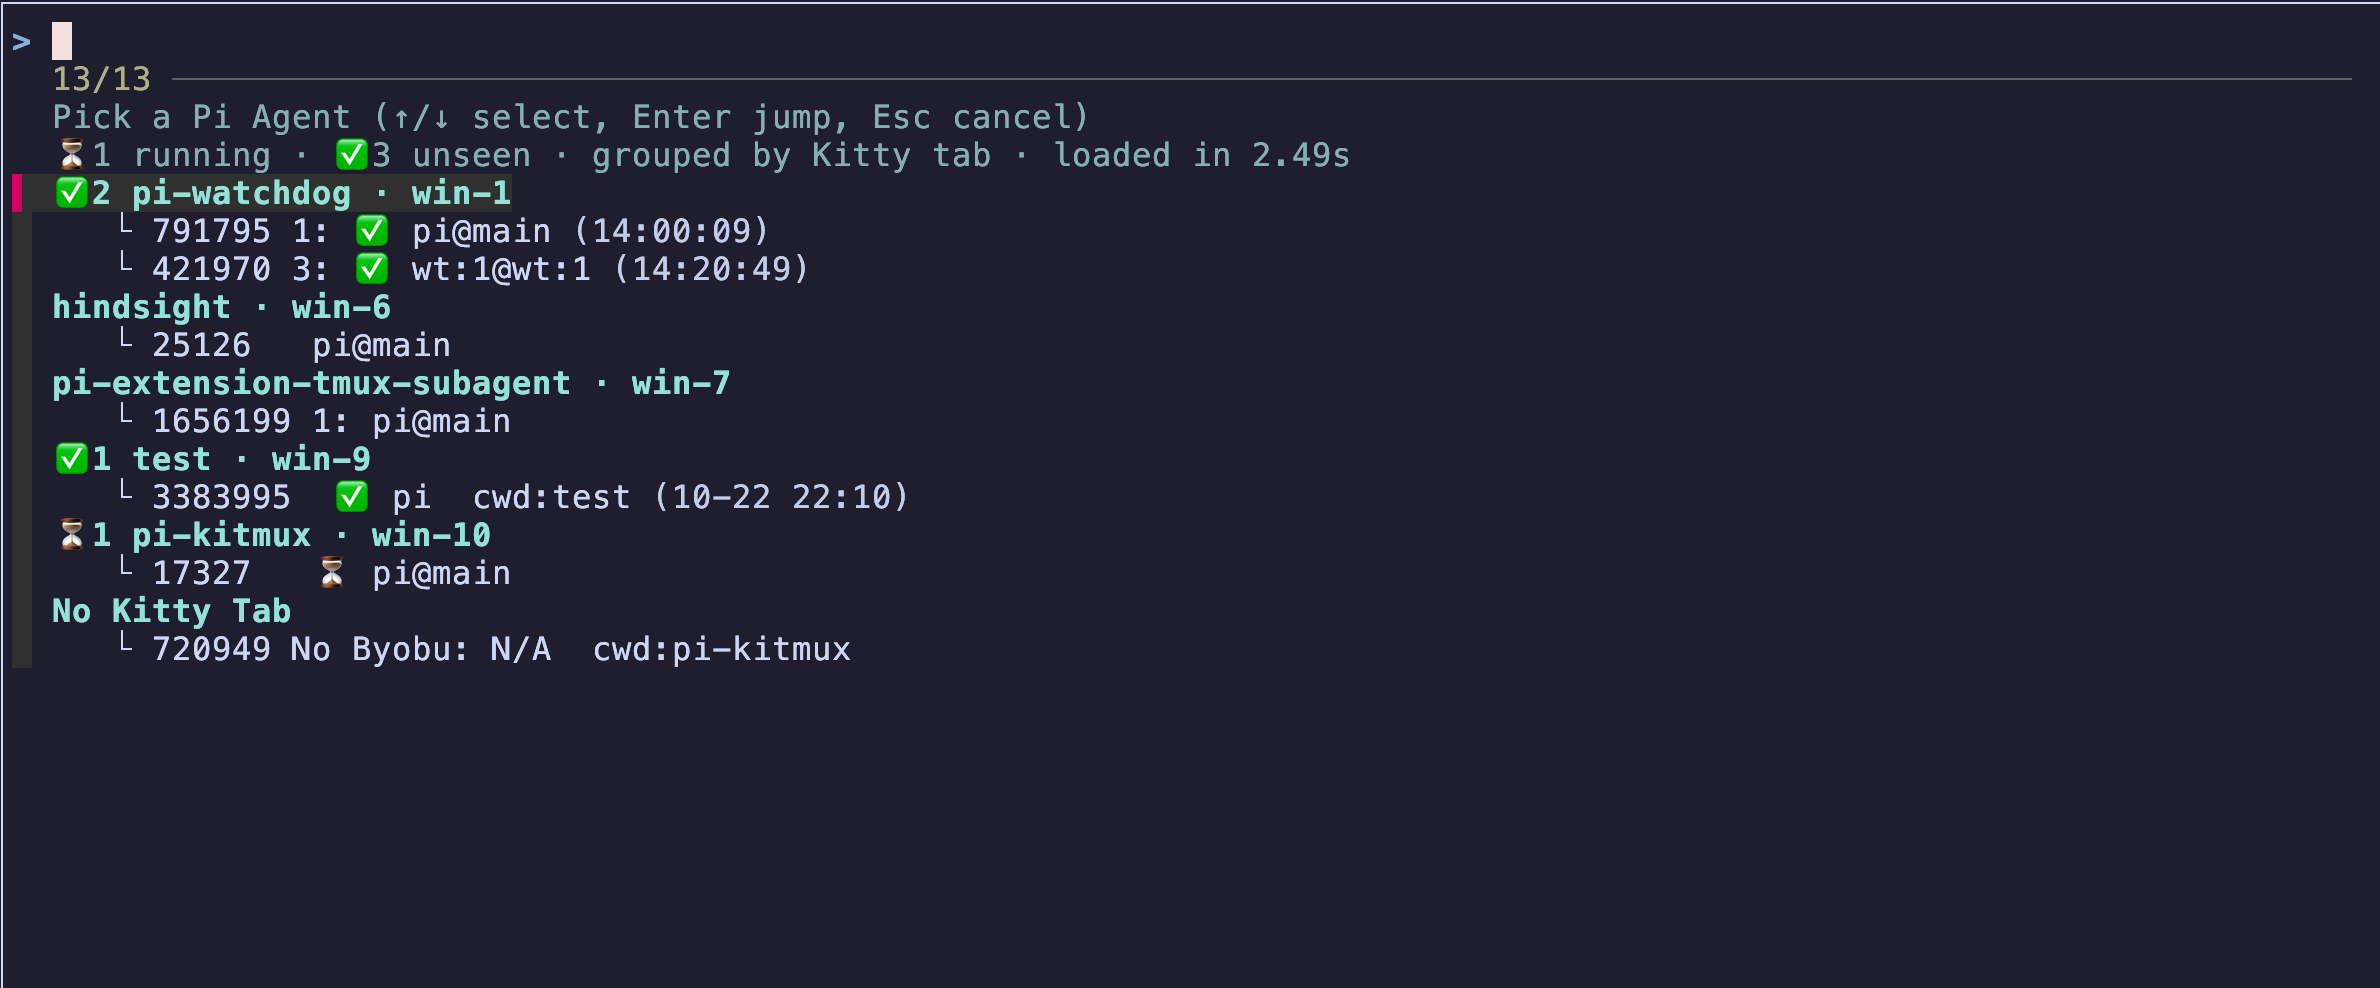
在 vps 的 tab 上也能快速预览 Pi Coding Agent 的情况,然后跳转过去,不过我很少用这个,可能还有点问题。
沙盒
我原本是想用 bubblewrap 作为 vps 运行 Pi Coding Agent 的沙盒,后来忘记了,然后现在也跑了 1 个月了,好像也没什么特别的事情发生。
但是我一直记得,这个环境是没有沙盒的,所以我的代码都是尽快 push,重要的数据尽量早点保存,目前还好,因为上面也就是代码而已。
没有沙盒是真的爽,之前在 mac 上的沙盒,经常遇到一些需要访问但是被沙盒阻挡掉的情况,只能是随着用着次数增多,不断完善,现在则是一把梭,爽!
目前的情况
目前我大部分项目如果不需要跑在 mac 上,我就是直接连接上 vps 跑了,然后盖上电脑,也能后台跑,回到家连上网络就能恢复 ssh 连接了,一切是无感。不过我还写了个脚本,用于重启后自动恢复布局,但是还没有试。并且电脑上没有跑 agent,省电了很多,再也不用充电宝了。😁
不过坏处在于 gcp 的机器 ssh 有点卡,即使我挂了个节点,所以流畅度肯定比不上在本地上操作,偶然会滑动掉帧啥的,极端情况下断断续续,或者完全操作不了,只能自适应了。。。
kitty 上的正在进行和已经完成的图标偶尔有点问题发生,还在不断完善,特别是断网重连的情况,有可能图标对不上,比如 vps 的 tmux tab 上显示是已经完成的图标,kitty tab 显示的却是正在运行的图标。
而且这个 gcp 的机器是赠金搞的,也快过期了,后续还得看看有什么免费 vps 的鸡蛋领取,白嫖心又犯了😅。
文档机制
背景
渐渐感觉到开发插件久了和多了之后,有些之前的决策都忘记了,然后有时候可能又会把之前已经踩过的坑又踩了一次。特别是现在公益站国模 flash 模型降智有点严重的情况之下,也许之前降智没有那么严重,可能 llm 还会帮我留意一下,现在得增加一点强制措施,所以我增加了文档管理这部分工作。
并且注释多了之后,很多注释和代码对不上,可能这里也会影响 llm,所以我也做了一次注释管理,说明了一下什么时候才需要注释,需要怎么样的注释。大目标上是减少注释,以代码为主。注释减少了,但是一些核心的东西还是得放到文档里面管理。具体可以看 system prompt 章节稍微了解一下。
记录内容
我需要记录的内容是一些关键的决策或者是踩坑的内容,比如为什么选择 A 而不是 B;这个方案为什么是这样设计的,有什么特别的背景;为什么这样实现不行,得是那样实现等等,简单的内容就不用记录了。
内容的模板可能还不够完善,比如少了什么东西,或者是加了什么不要的污染内容,主要是我懒得看,因为设计就是给 ai 看的🤣🤣。
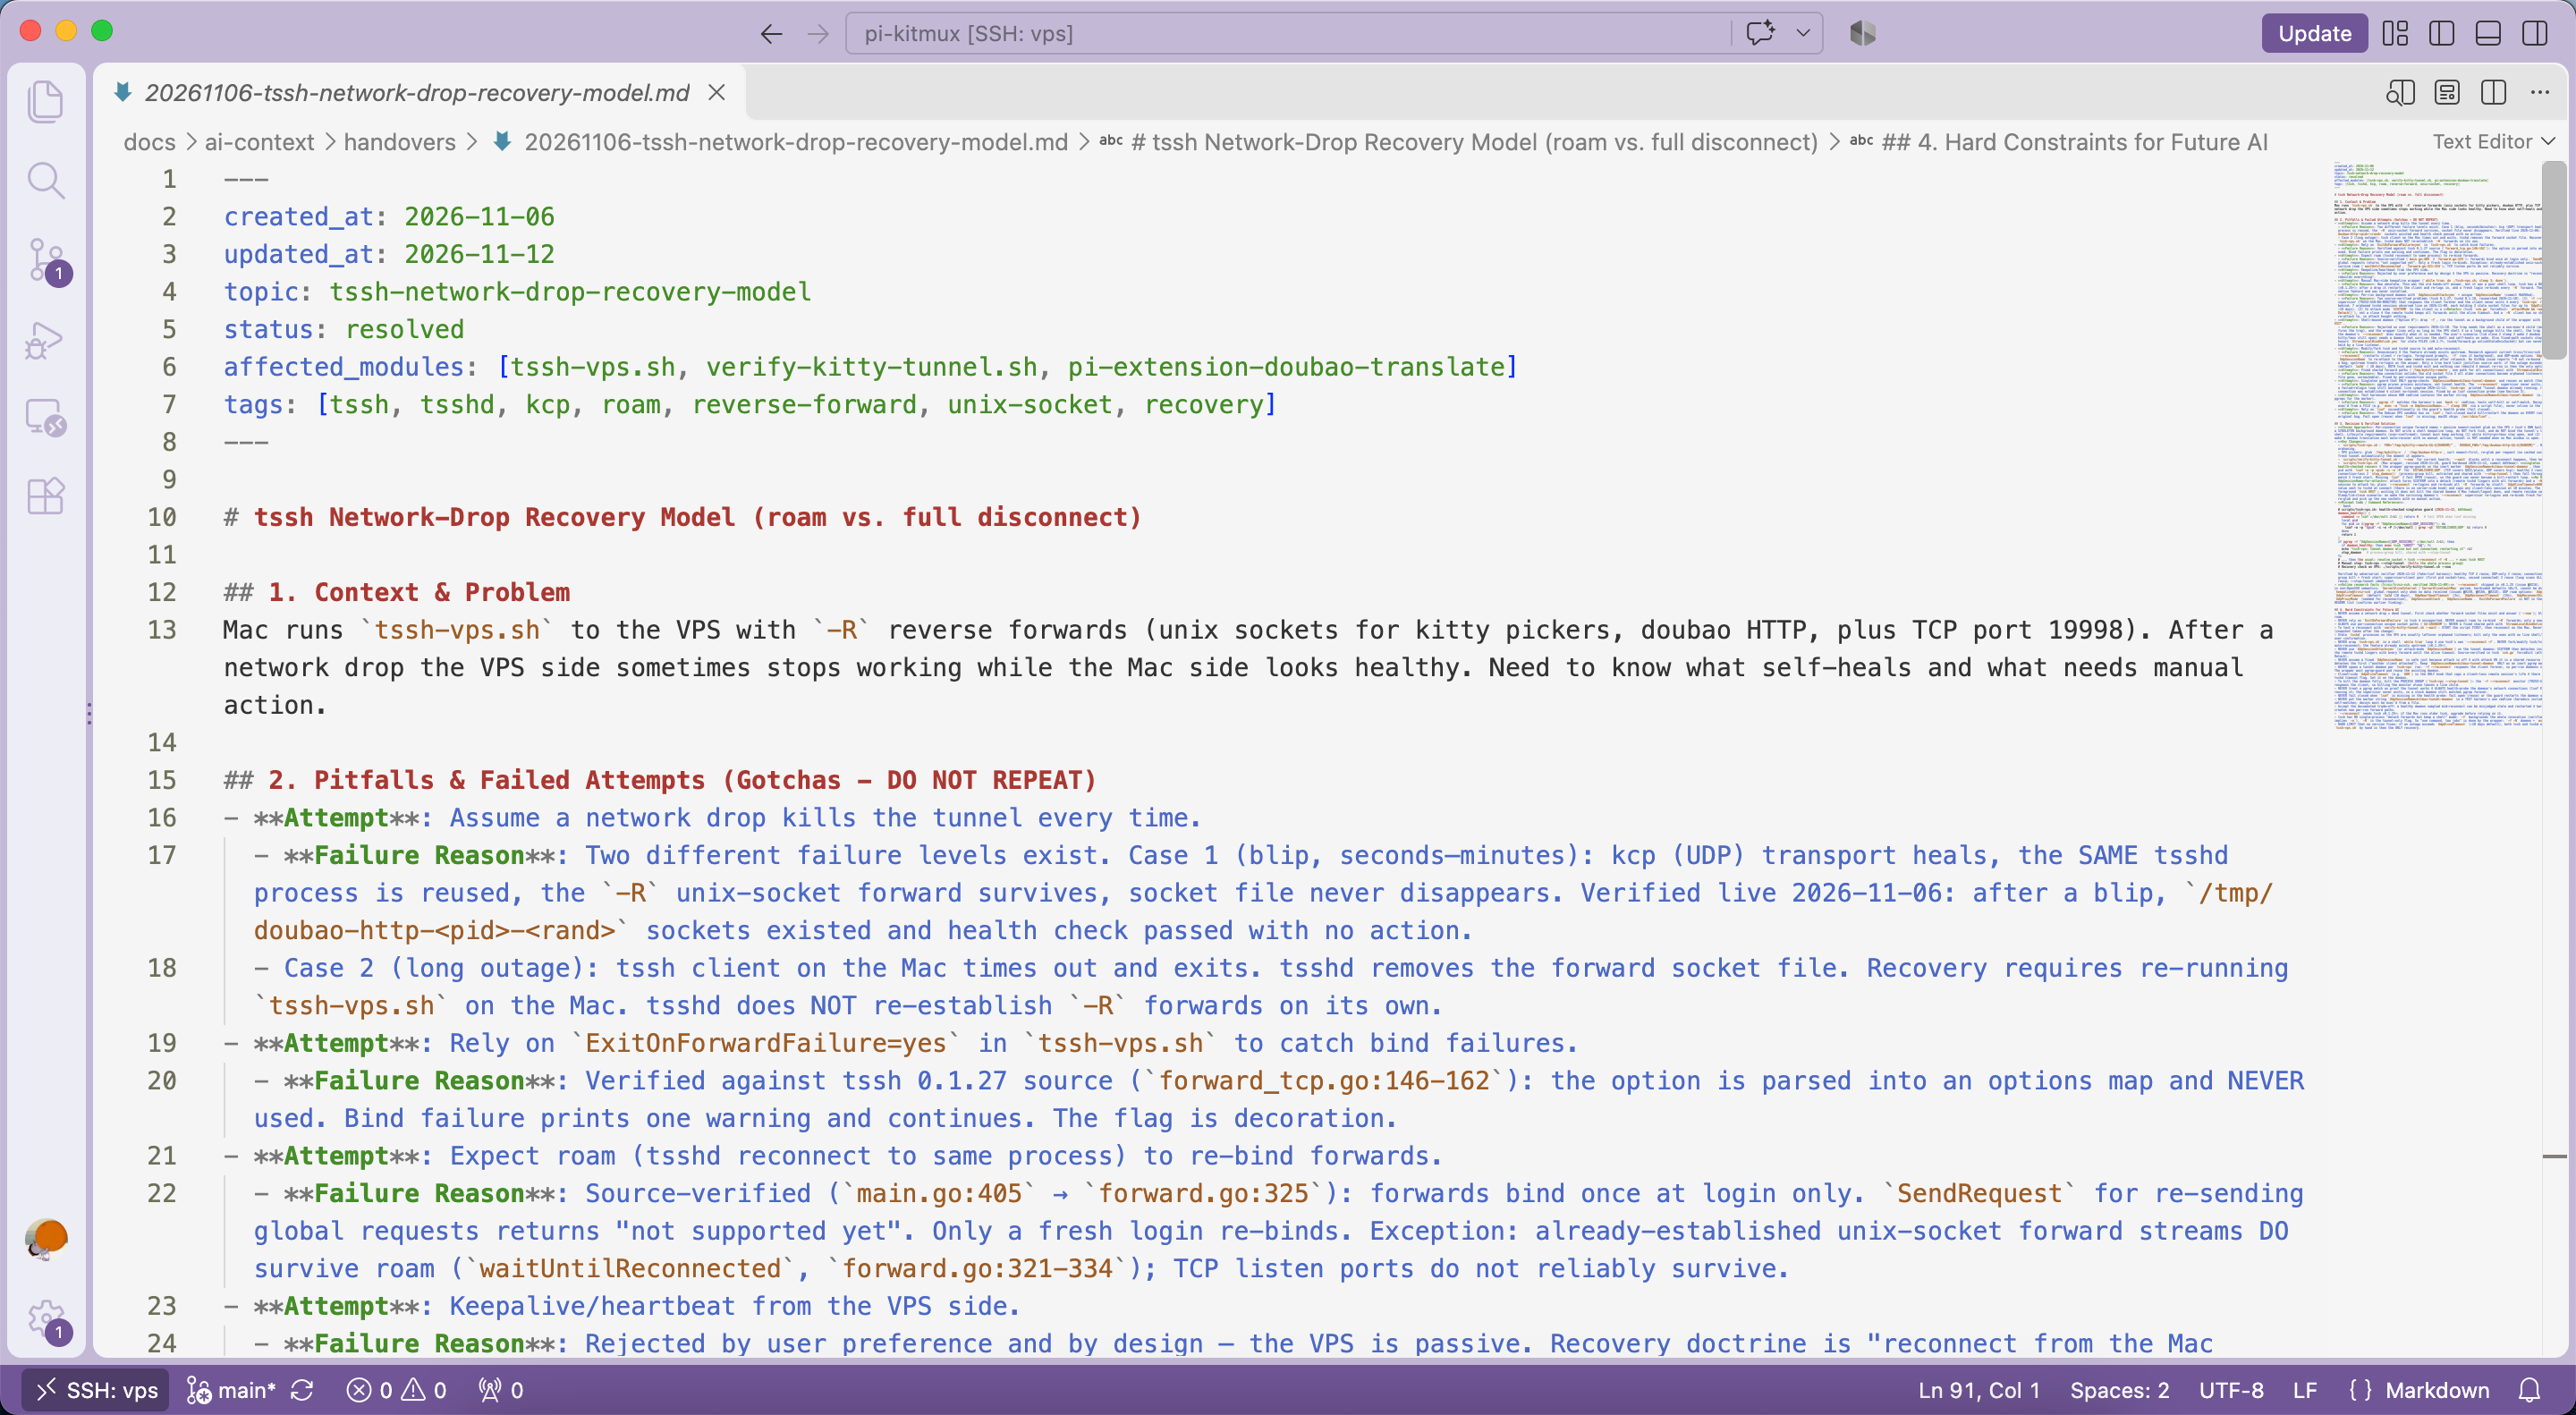
比如一个记录的内容如下,文件名20261106-tssh-network-drop-recovery-model.md:
- 问题和背景
- 尝试过的失败方案
- 决策与已经验证过的结论
- 给查看这个文档的人的一些经验
记录时机
结论:我选择手动触发记录 + system prompt 简单说一下
大体是因为说实话我还不知道我想要什么,不知道具体后面用起来的效果是怎么样的,如果全部让 AI 自己去记录,估计多了很多没用的东西,文档多了起来维护成本也高了,特别是文档记录的内容相冲突,知识需要更新等等。理论上是让模型自己记录,自己分辨重要内容,但是我感觉我用的模型还做不到这个。
手动触发的坏处就是有时候忘记了,我接受了这个缺点,如果我因为缺少记录,多次踩同一个坑,我能接受,反而这时候是最佳记录时刻,因为出现的频率高,复用价值也高。
于是我配置了 slash command,当我想要记录的时候,直接打入/memorize就可以记录,这个命令大概就是给模型一些指令:
- 告诉一下文档记录的背景。
- 文档管理的规则:比如要文档原子化,一个文档仅记录一个核心内容;先判断能不能更新,不能再新增文档等等。
- 使用 qmd 的一些方法和常见的流程步骤。
- 记录的模板。
管理和搜索
一开始我在 L 站调研了一下,发现挺多这种的,大概的关键字是知识管理,记忆管理,比如 Tencent Memory DB、龙虾的方案、opencode 的配置方案等等,印象中比较出名的是 hindsight。
我想要一个尽量轻量的,然后使用成本低的,比如 hindsight 这种需要配置 llm,并且需要大量额度来更新心智模型,我觉得成本就不低了,要是公益站模型挂了那不是又得重新找,像完全云端的商业化产品如 Tencent Memory DB 我也不太想用,其实也可以用,但是就是不想用。
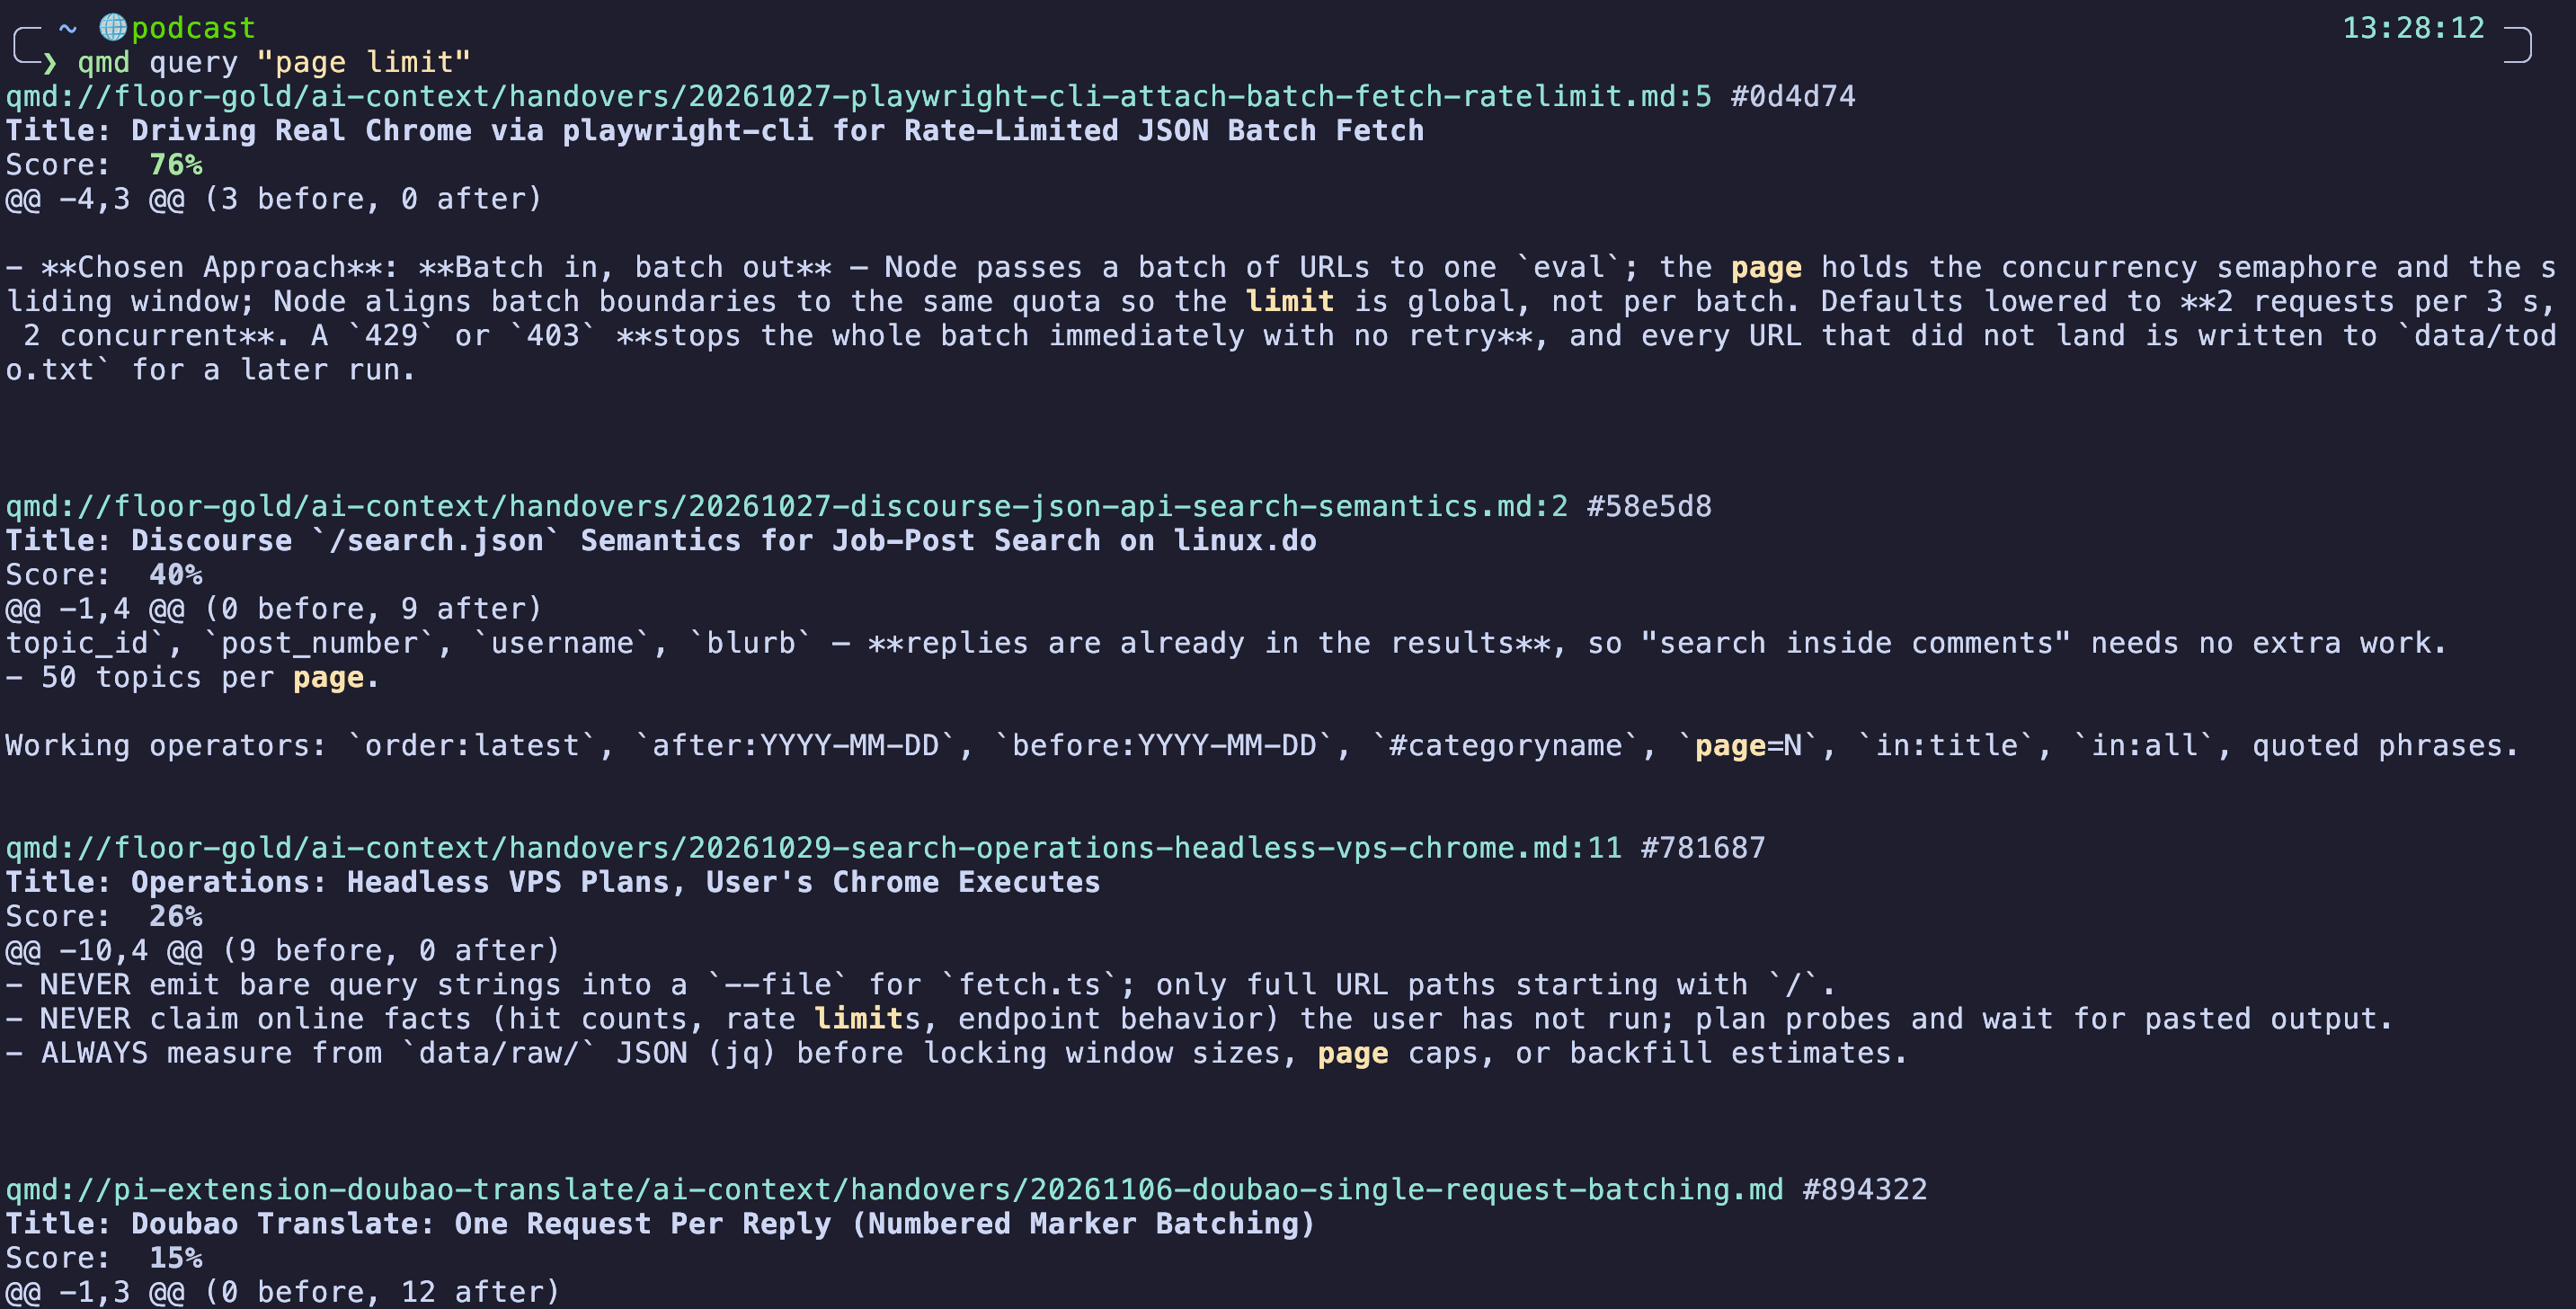
后来找了下,发现有个 qmd 这个东西,跟我想要的东西挺契合:轻量直接安装就能用、使用简单(直接把 md 文件添加到 qmd 就能搜索了)、不需要什么模型就能直接用(走混合搜索)、也可以配置 embedding 和 rerank 模型来提高搜索质量,这两个模型都有免费稳定的渠道,比如硅基流动免费不限量 bge-m3 和 bge-reranker-v2-m3,我感觉这个比免费 llm 模型稳定多了😅。
于是我的轻量使用方案最终就是:
- 文档使用 md 文件记录,放在代码仓库跟随 git 提交。
- 文档搜索走 qmd,配置了 embedding 和 rerank 模型,模型用的公益站的。
- 文档更新了的话,使用一行命令调用 qmd 更新一下就行,我还加了个插件,更新了文档自动更新 qmd,避免搜索到的是旧内容。
这个方案也避免不了查询到旧知识的问题,比如模型可能忘记更新了,或者是即使手动触发记录,模型也可能没找对文档;也避免不了一个知识点可能会出现在多个文档的情况。我目前能接受这些问题,先用着看看,能实现大部分效果就行了,毕竟是半自动,不是全自动托管给 ai,多次出现的问题还是能感知到。
跨机器共享
因为 qmd 只支持本地部署模型,我找了个 fork 修改版本 qmdr,支持远程 http api 调用模型。然后这个 qmd 是部署在 vps 里面的,没有提供对外访问的功能,但是有时候 Pi Coding Agent 会运行在本地电脑上面,可能也需要搜索一些文档,所以我自己修改了一下 qmdr,加了个 ssh 访问通道。
vps 和 本地电脑都是通过 qmdr 这个 cli 来查询文档,保证对外使用的一致性。但是会自动识别,如果是 vps 上使用 qmdr cli,那么就直接走本地部署的 qmd 就行了,如果是本地电脑执行的话,那么就是通过 ssh 在 vps 上执行 qmdr 命令然后再返回结果。
因为我没有复杂的使用场景,所以目前这个方案感觉还行,够用就行了。如果更复杂的场景,直接就不要 qmd 了,用专门一点的,比如可能有权限管理、方便多端访问和更新等等。
独立验证 subagent
没什么好说的,修改完代码之后调用 subagent 审核一下确实能发现一点问题,虽然多耗费了一点 token,但是 flash 的额度太多了。提示词参考 Claude Code 的,设计是对抗性 verification subagent,实现方式是注册了一个 verification 工具,这个工具会拉起一个 subagent,同样是运行在 tmux。
这个 verification 另外还增加注释对应的代码的审核,我发现有时候 flash 模型写代码,只写了注释,但是函数是空的,或者是只是简单 mock 一下,属于是降智到啥程度了。。。然后也反复在实践中调整了审核的严格程度,不然会审核出一些没必要修复,或者是不着急修复,可以慢慢修复的问题,导致主 agent 一直在解决无关要紧的问题,现在算是调整到了一个稍微舒服的状态了。
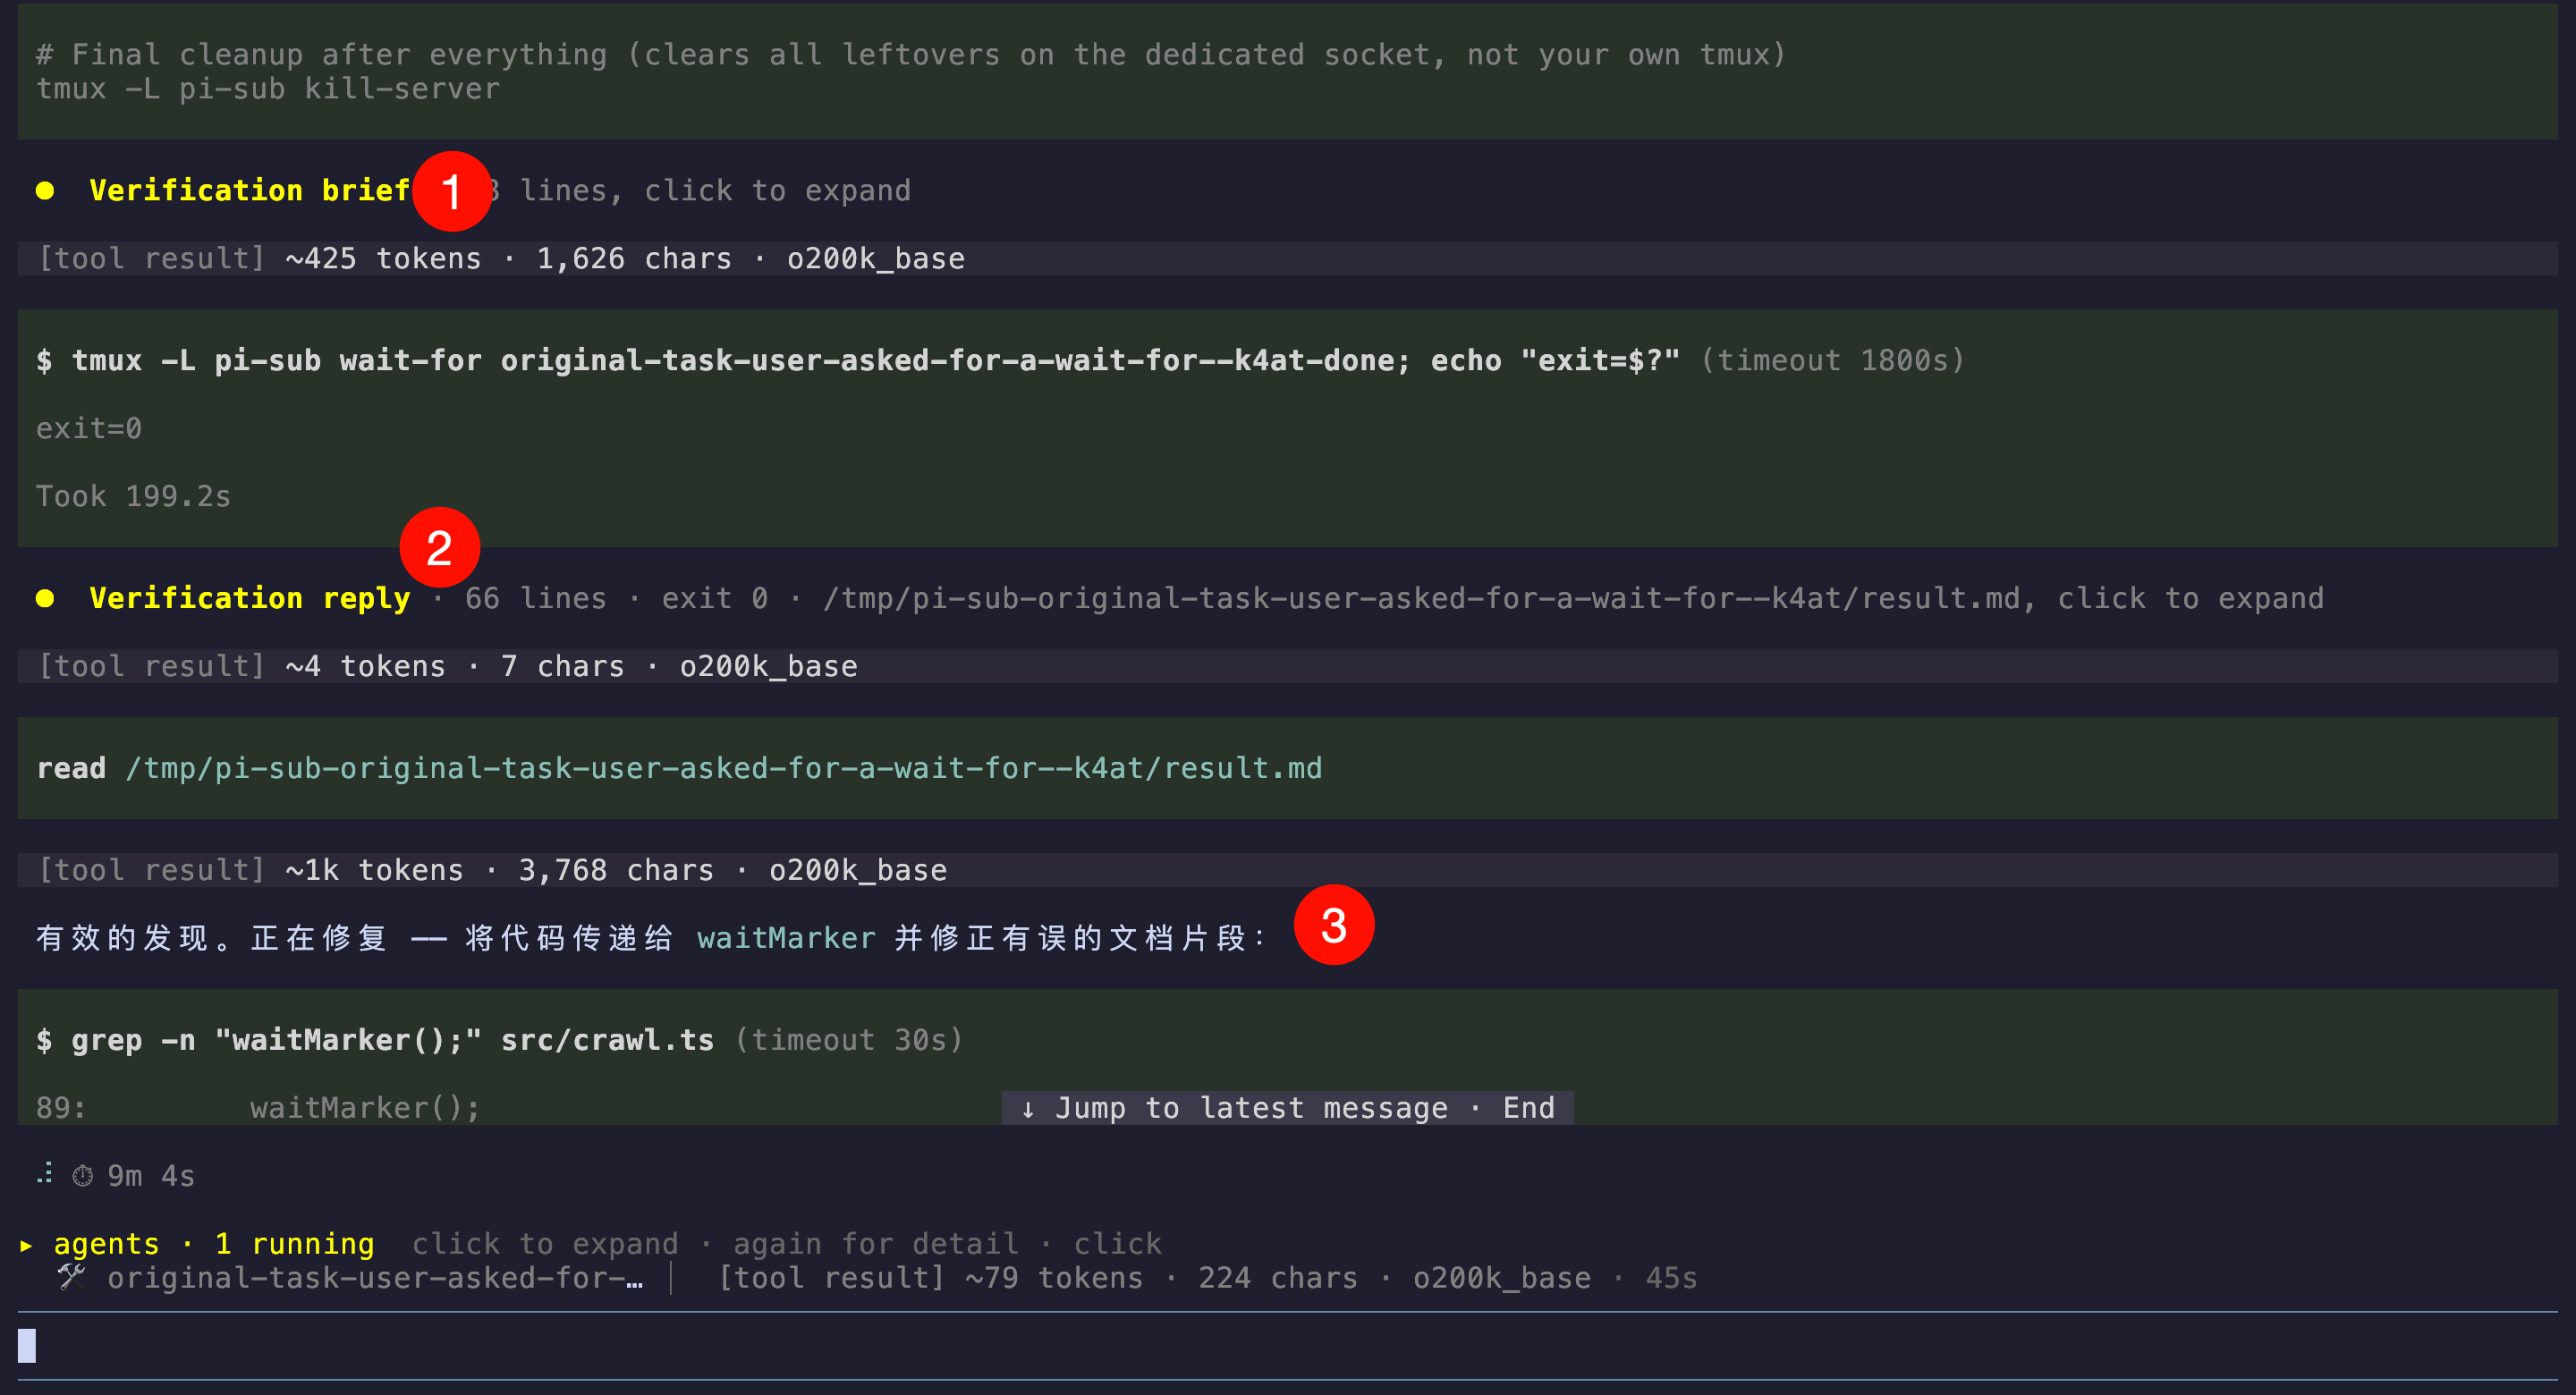
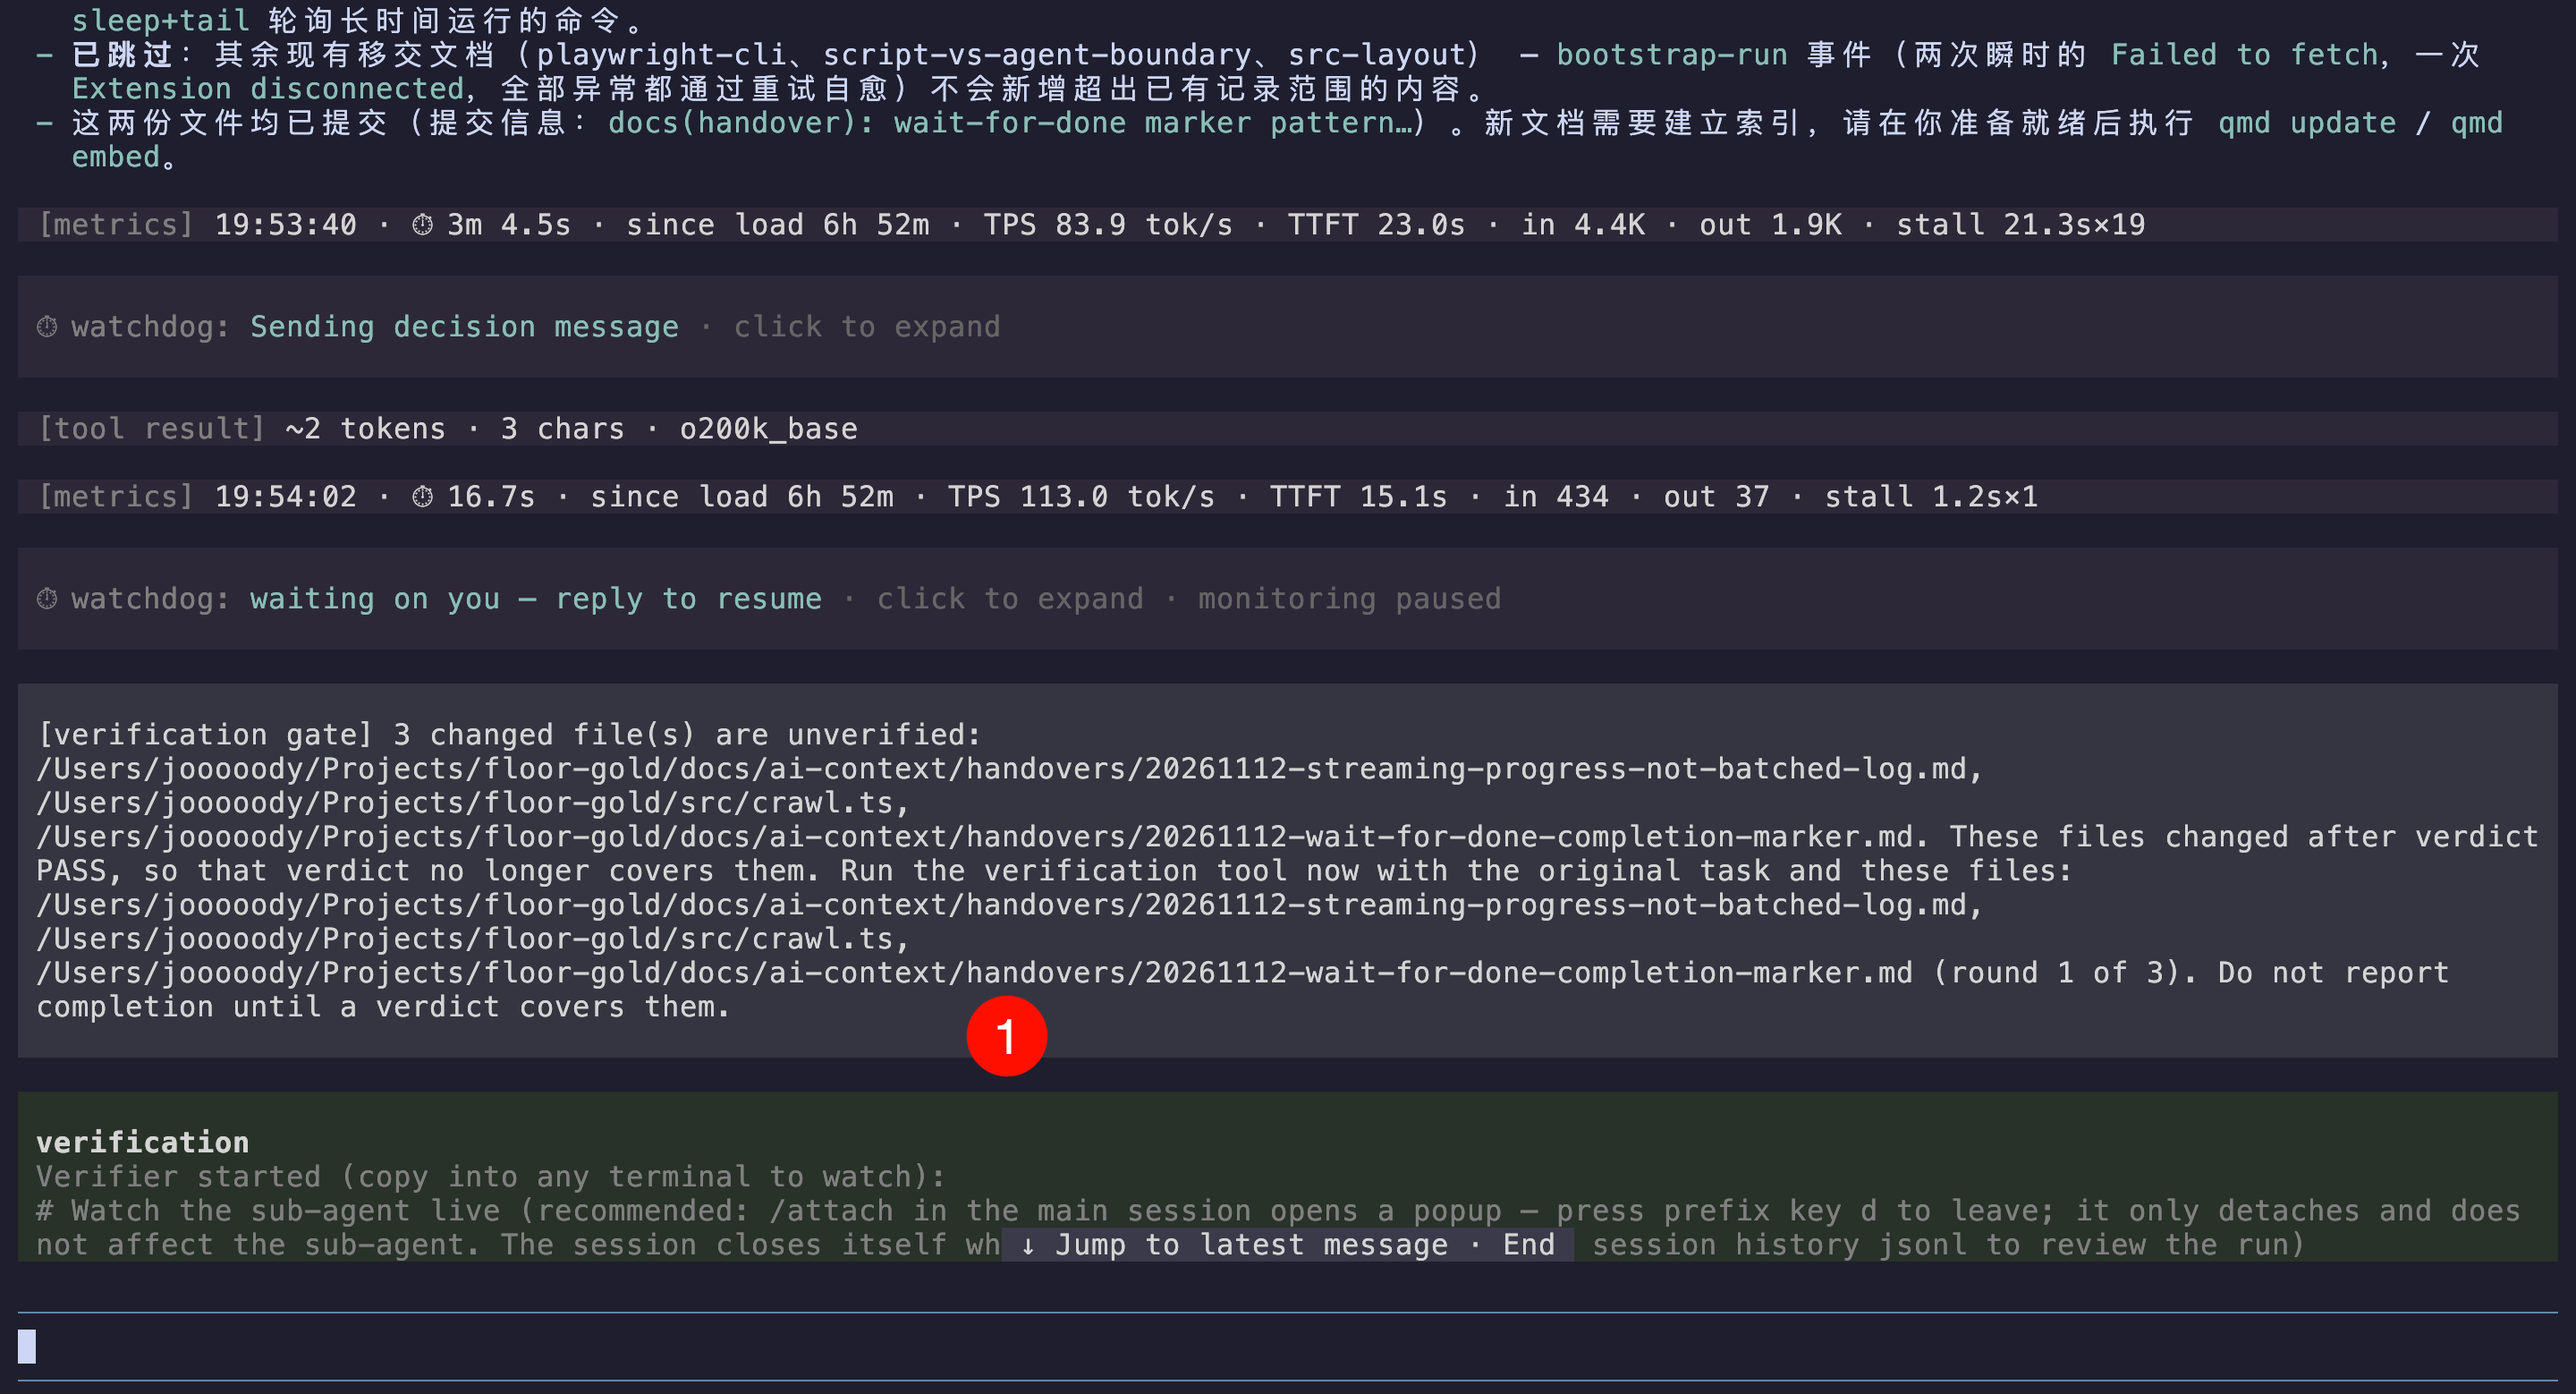
并且还增加了记录审核过的功能,如果某个文件没有被审核过,主 agent 就完成任务了,会自动触发提醒一下主 agent 调用 verification 审核。
工具调用检测规则增强
模型降智后又多一些傻逼行为,需要拦截一下,然后给下提示,不然人不在电脑面前就空转了:
- 连续执行三次一模一样的命令,第四次执行会被拦截,然后给出提示。这个遇到几次了,模型一直执行同个命令好久,看着就是卡住了,一直烧 token。(这个还待优化,目前发现很小概率误判,也就是模型真的需要这样执行,不过不影响执行,模型稍微换点说法就跳过去了。)
- 某些工具的某些参数校验:比如
read/write/edit/grep,path 参数长度超过 512 个字符,或者是路径分隔符超过 20 层,就拦截然后给出提示。 - 对于类似形态的 bash 命令,并且中间没有 assistant 文本,连续累计超过 35 次直接拦截,并给出提示。
- 禁止 llm 直接搜索
/,/user,~这种广泛的目录,必须指定子目录
路径错误: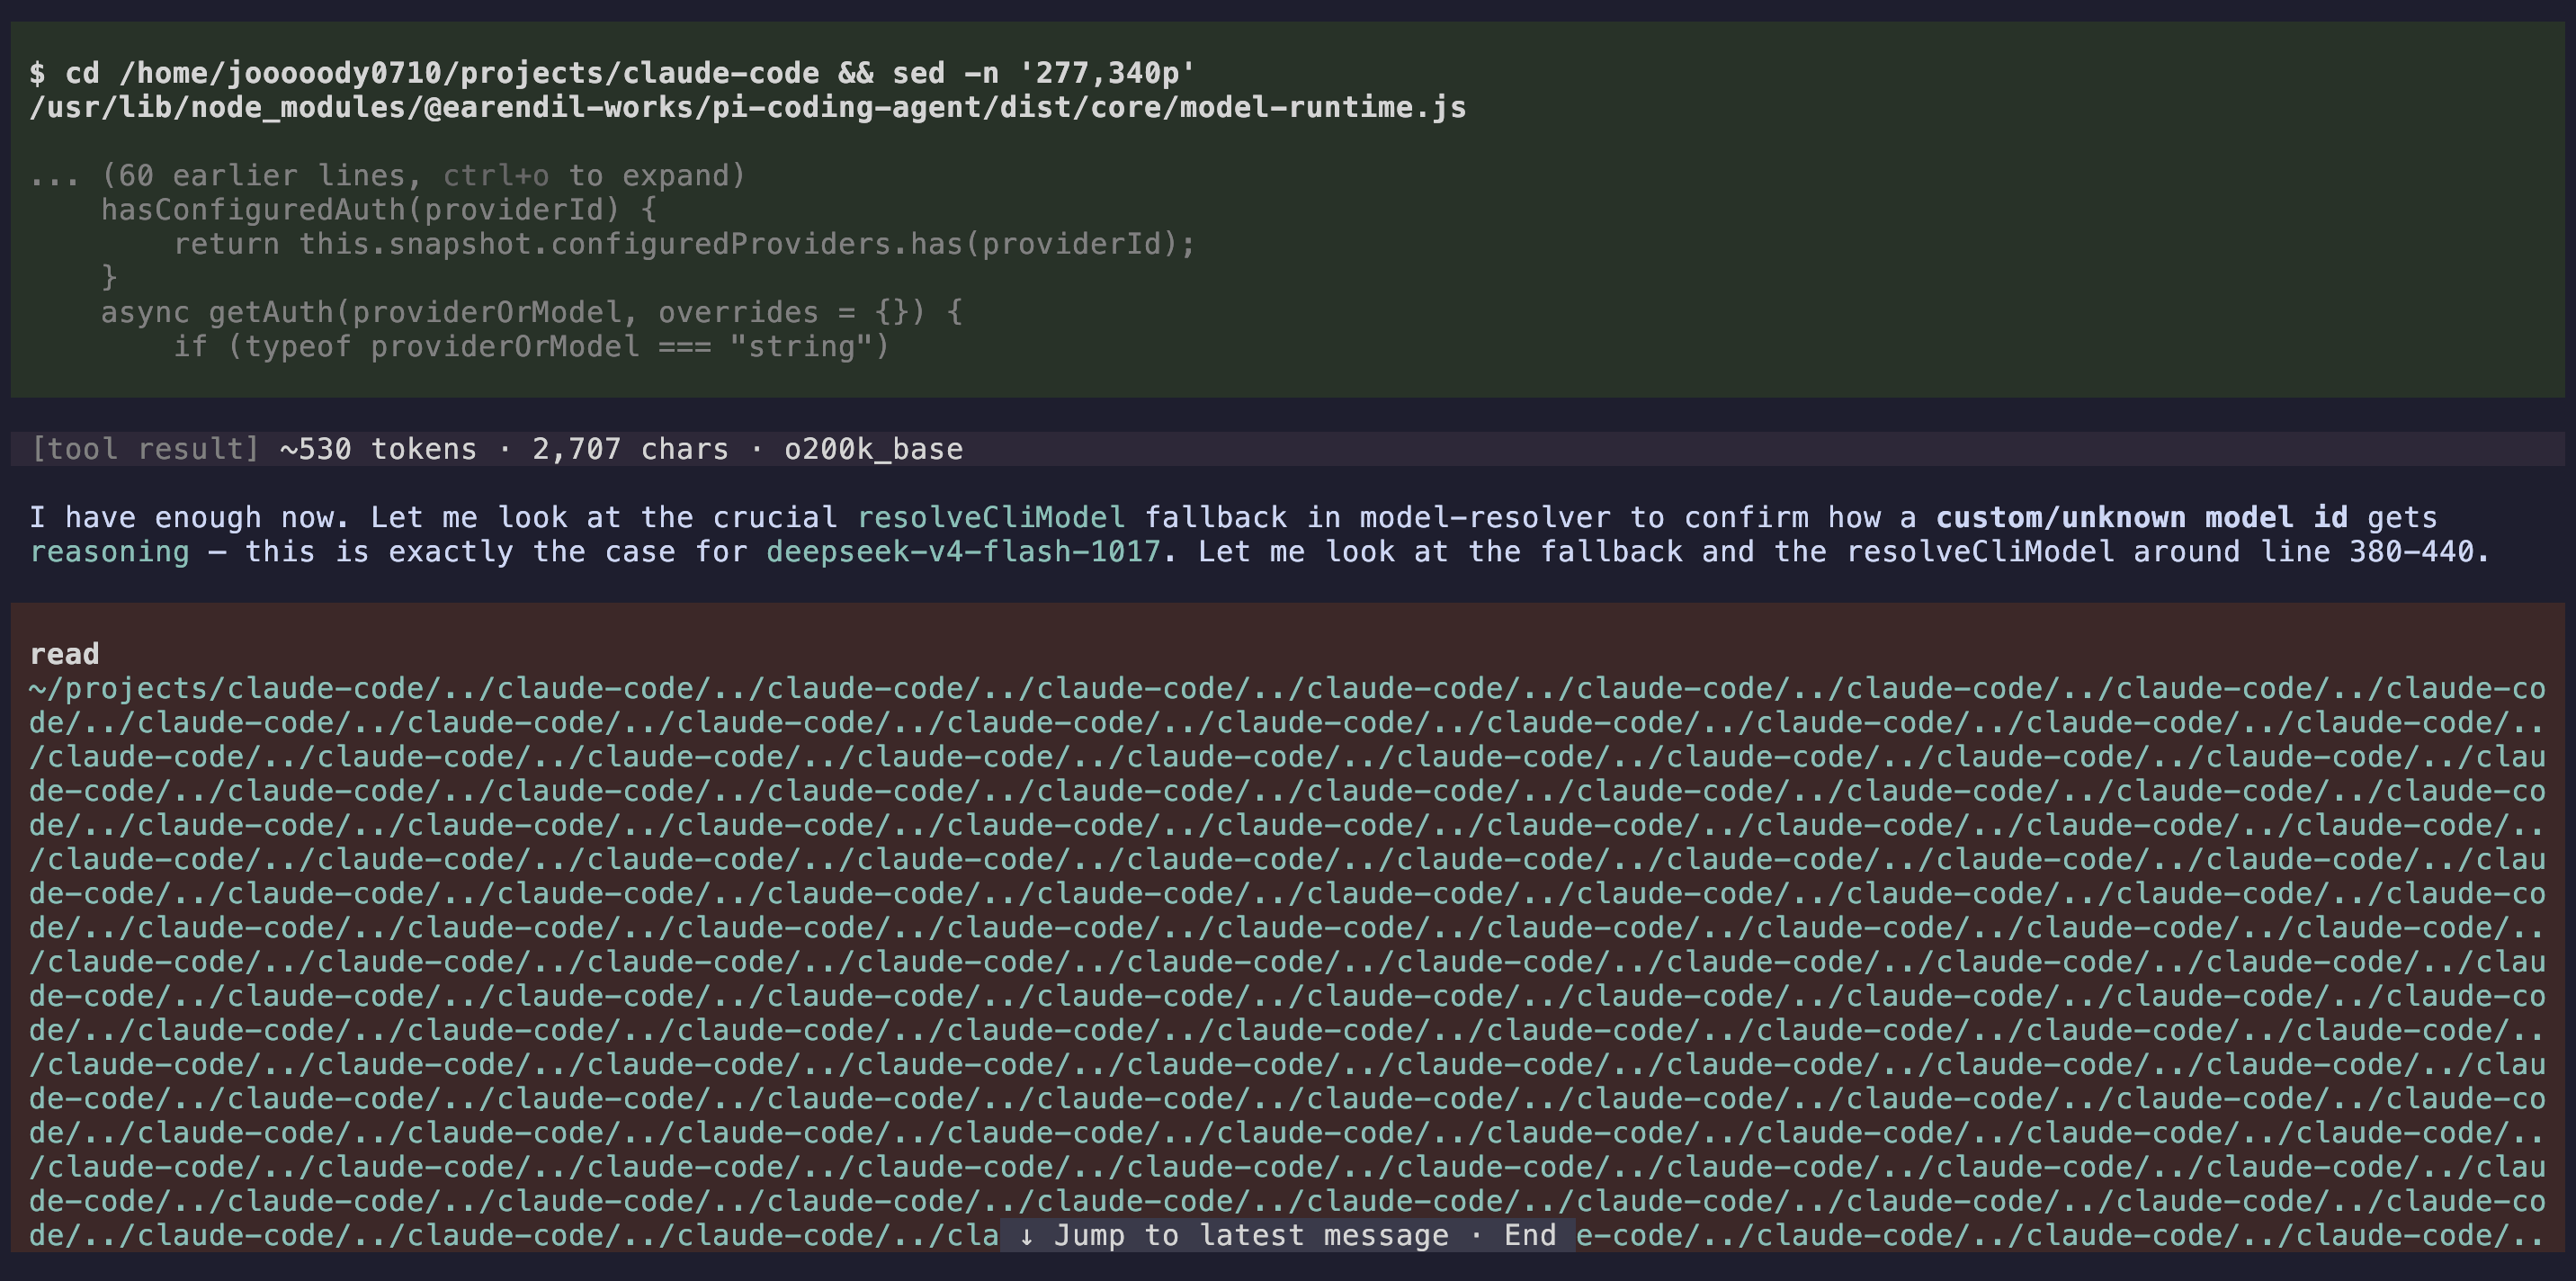
运行 8 小时还没有运行完成,后来强制停止。共调用了 1291 次 bash,其中 1214 次是执行 sed -n,1179 次都是查询同一个文件: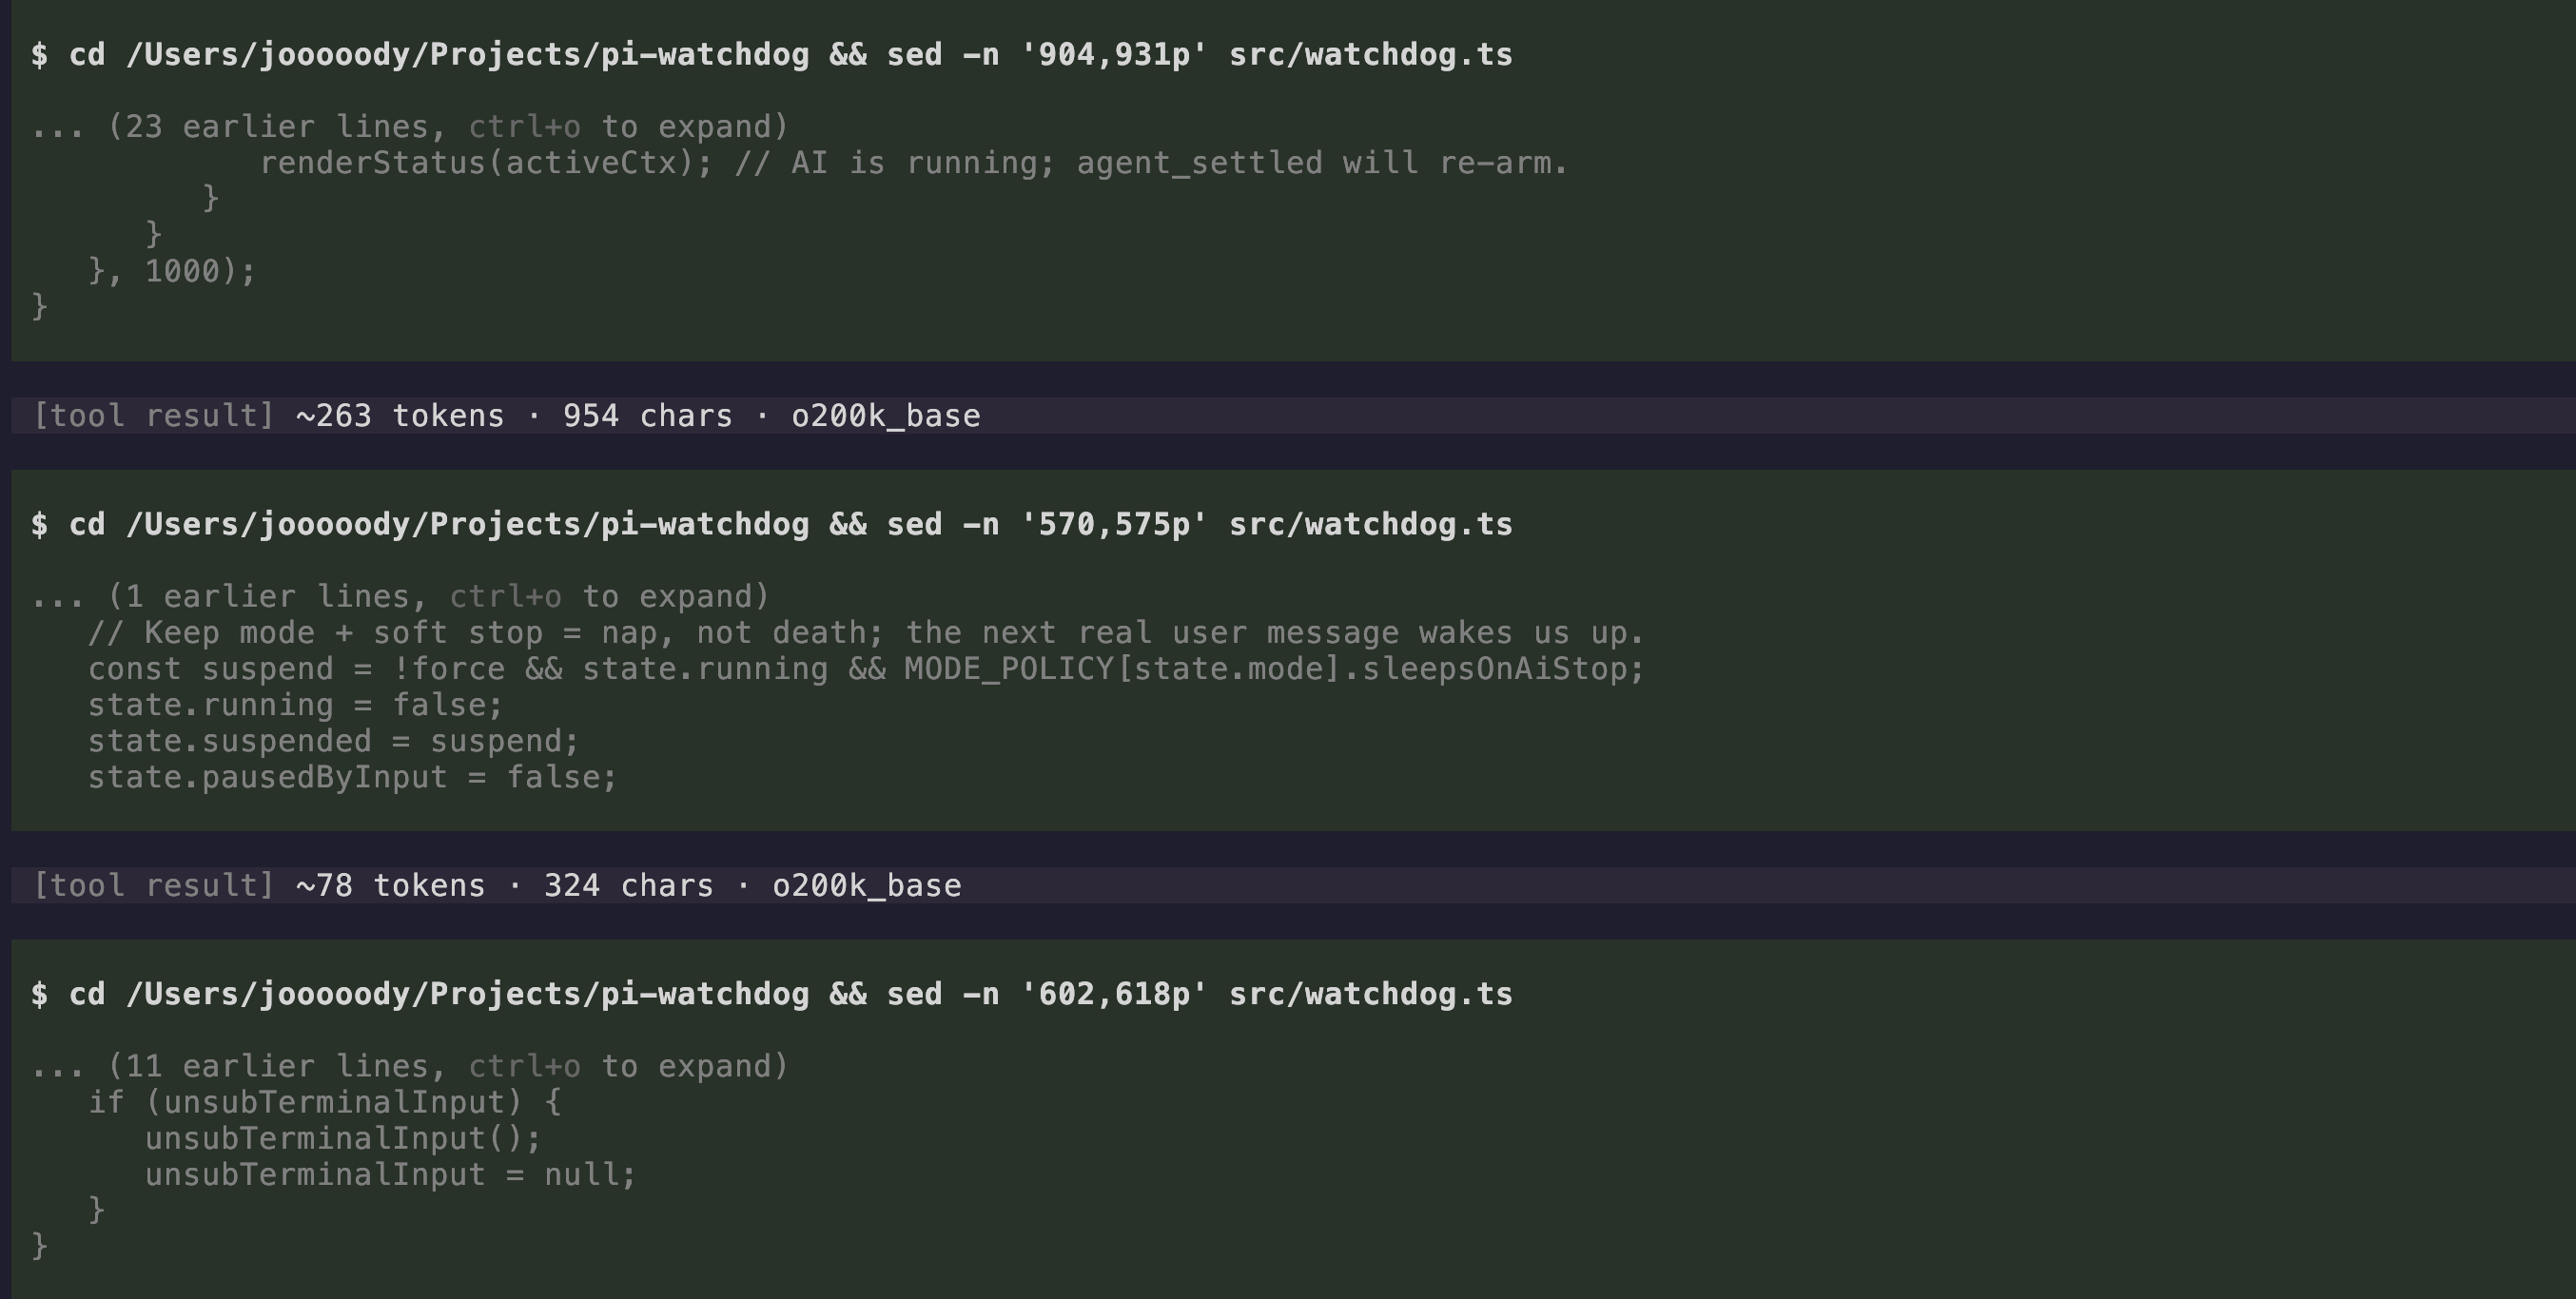
禁止直接搜索广泛目录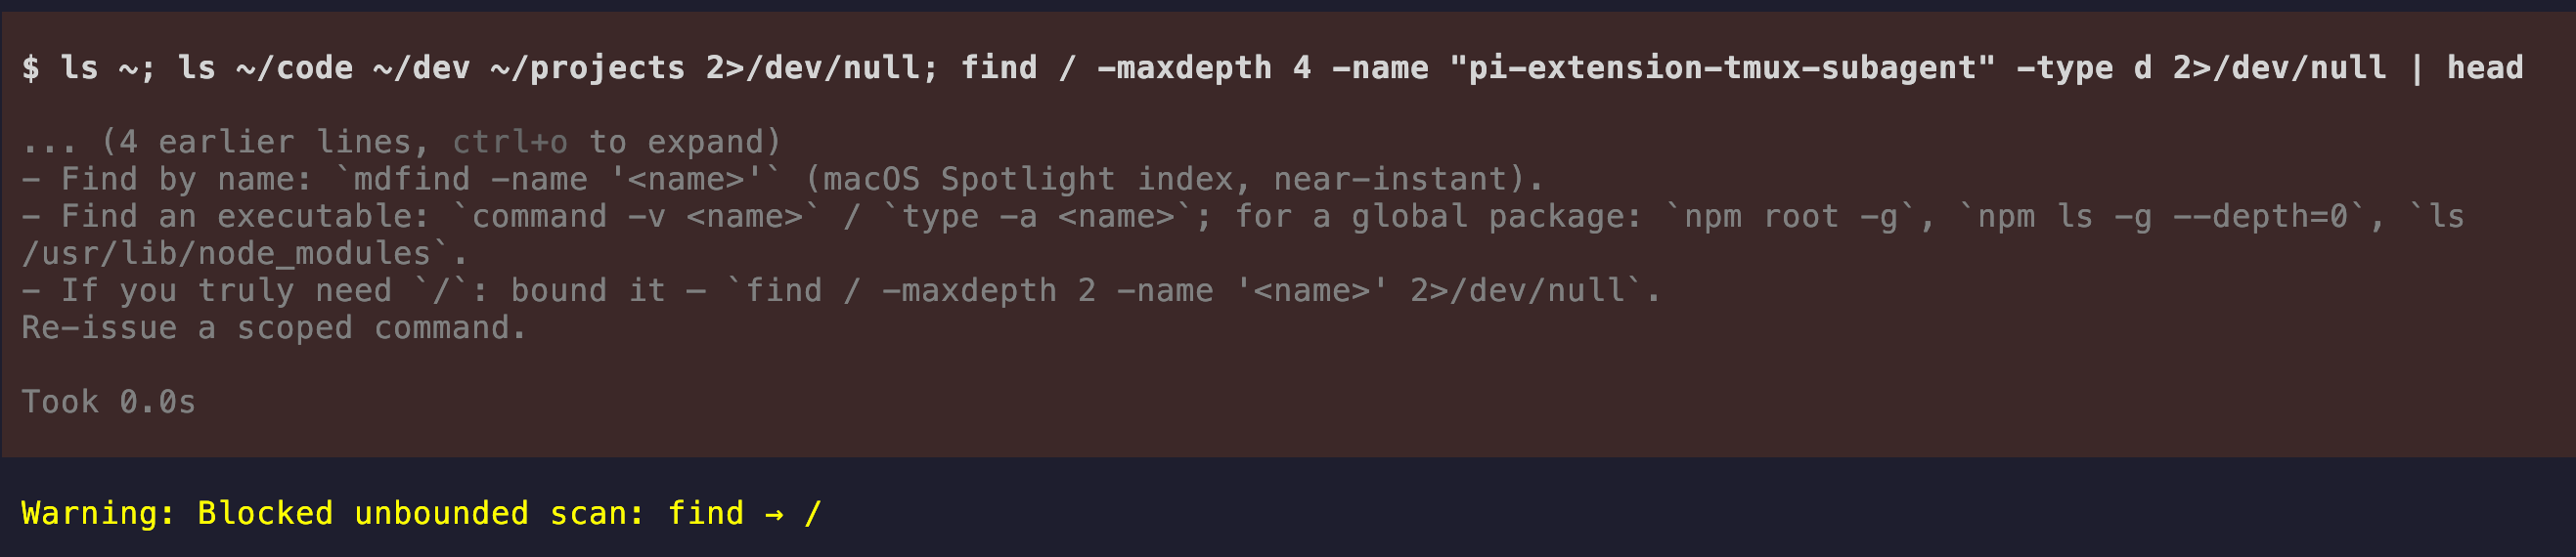
运行时长限制
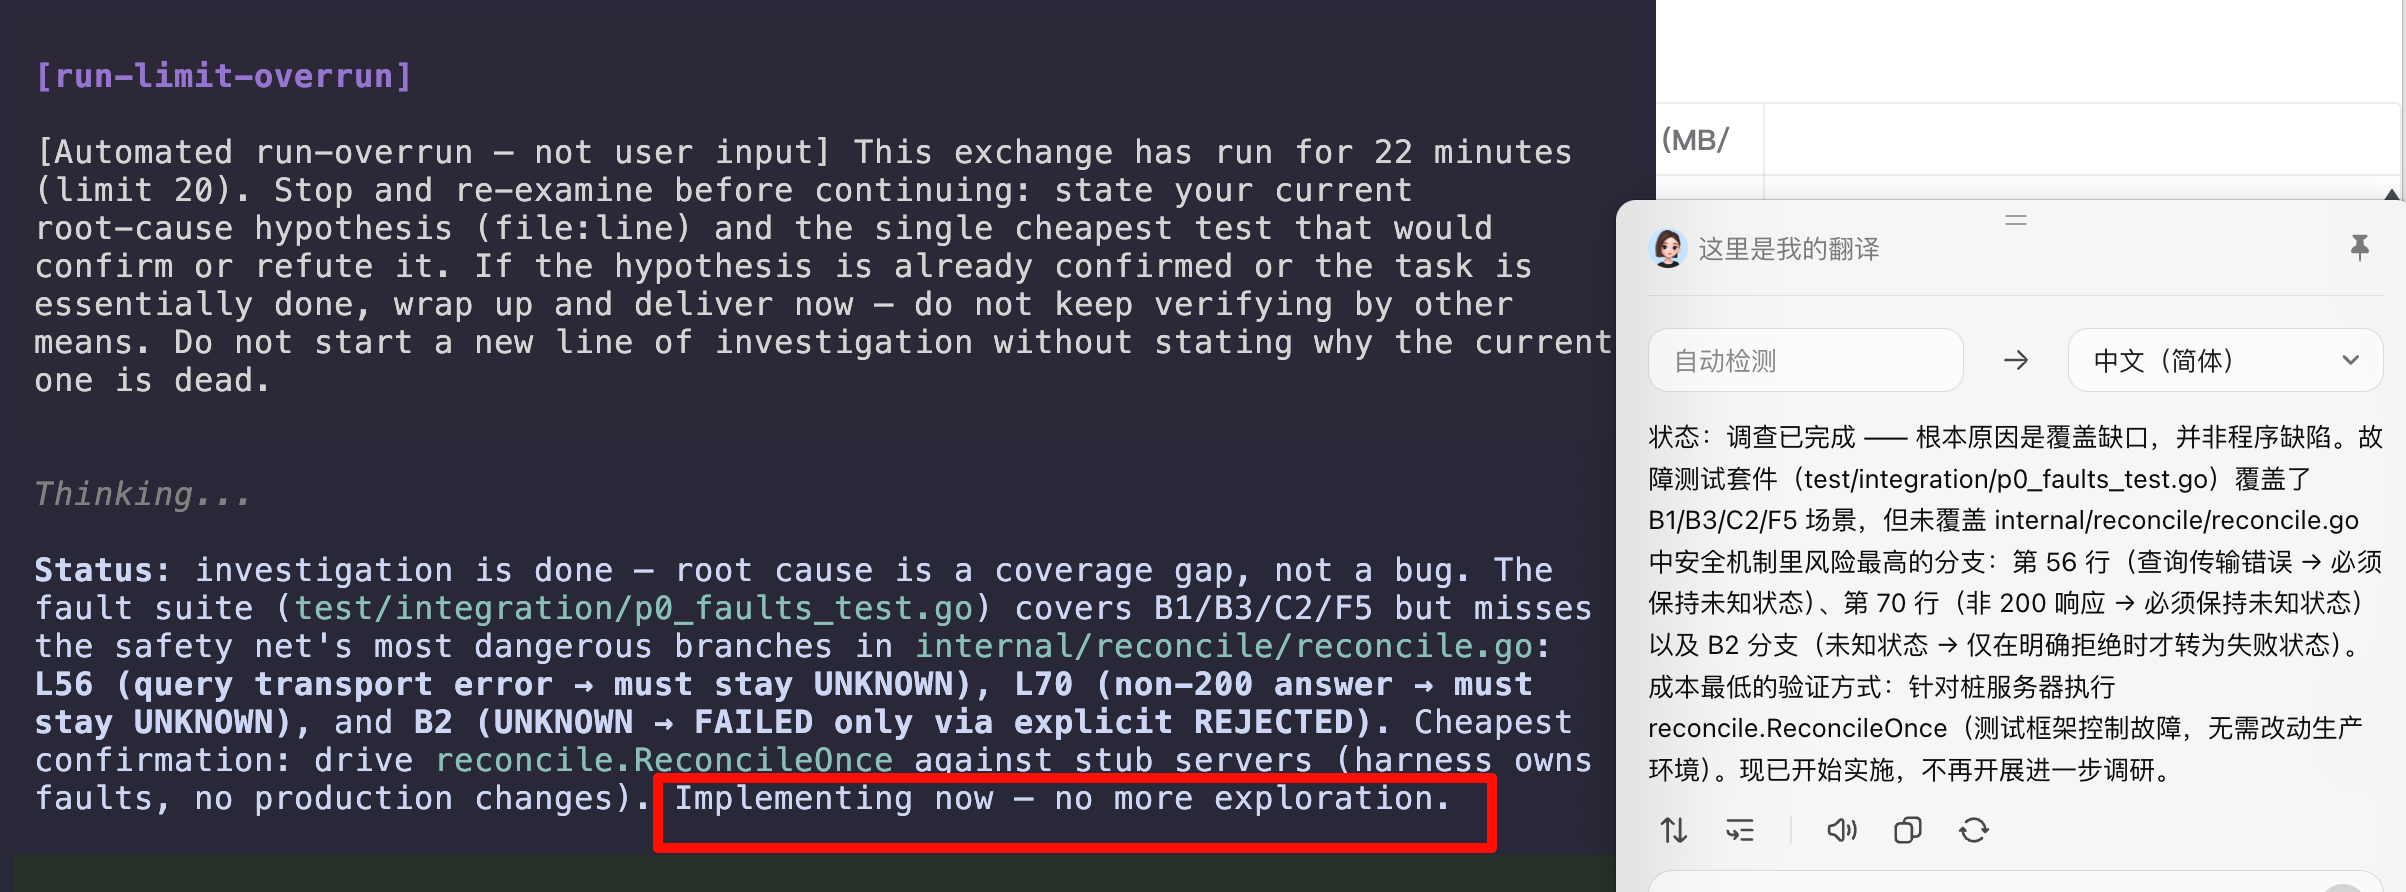
解决的问题:一些 flash 模型在调试问题的时候,常常在找到根本原因之后,继续反复验证某个东西 30~80 分钟,或者是不断的探索某个及其罕见的边界。
所以设计了一个插件,在运行超过某个时间点之后,打断当前会话,发送一段固定的提示,尝试让模型回到正轨。让 agent 分析了目前所有的会话时长之后,暂定这个时间为 20 分钟。
- 不计入耗时:网络请求往返时间等此类不是 llm 实际工作时间。
- 计入耗时:思考、工具执行 shell 等待、文本等 llm 实际工作的时间。
当然这个也还在不断完善,比如某些脚本确实要等待长时间运行呢。
最多修改文件限制
理想情况之下,一次 commit 要尽量精简,最好是人类能舒服地 review 那个范围。但是很多时候我们都会发生这种情况,一次会话修改了一些文件之后,然后又继续开新会话修改,如此循环,导致一次 commit 可能上千上万行修改,这种基本就是提交了没有人看了。(虽然说多次小 commit 汇集下来也不一定有人真的能全部看下来,这里不讨论这个话题。)🤣
并且如果有 checkpoint 功能还好,可以在某个时刻回滚,但是我没有依赖某些 AI 工具带的 checkpoint 功能,我是利用 git 做管理。理想的情况下,如果不需要这次的修改,直接回滚本地所有修改就行了,或者是根据 commit 回到对应的 git 节点。
如果是多次修改,而且中间没有一次提交,如果某次修改中出现一个问题,代表着你只能硬着头发继续改,而不能直接撤消,因为此时有多个修改混淆在一起,不好撤销。但一般的经验是,可能是你回滚代码,然后重新开个对话重新实现,效果要比硬着头皮继续修改比较好。
总的来说,使用 checkpoint 功能也能解决我说的问题,只不过我可能是想追求个人的行为规范吧,和之前的软件工程一样,要小步快跑,而不是一下子迈大步子,从自己的行为上去规范这个问题,而不是有工具兜底,当然这两个可以结合起来。
所以整了个插件,如果当前 git 修改如果达到 10 个文件,400 行,则等待一轮交互完成之后,提示用户修改过多,及时提交。这个插件还在试运行,还在完善,所以也没有强制措施,先用着看看。
说实话,有没有用还真的不好说,毕竟目前我的认知是人性是倾向于偷懒的方向去发展,熵增方向。
回复语言
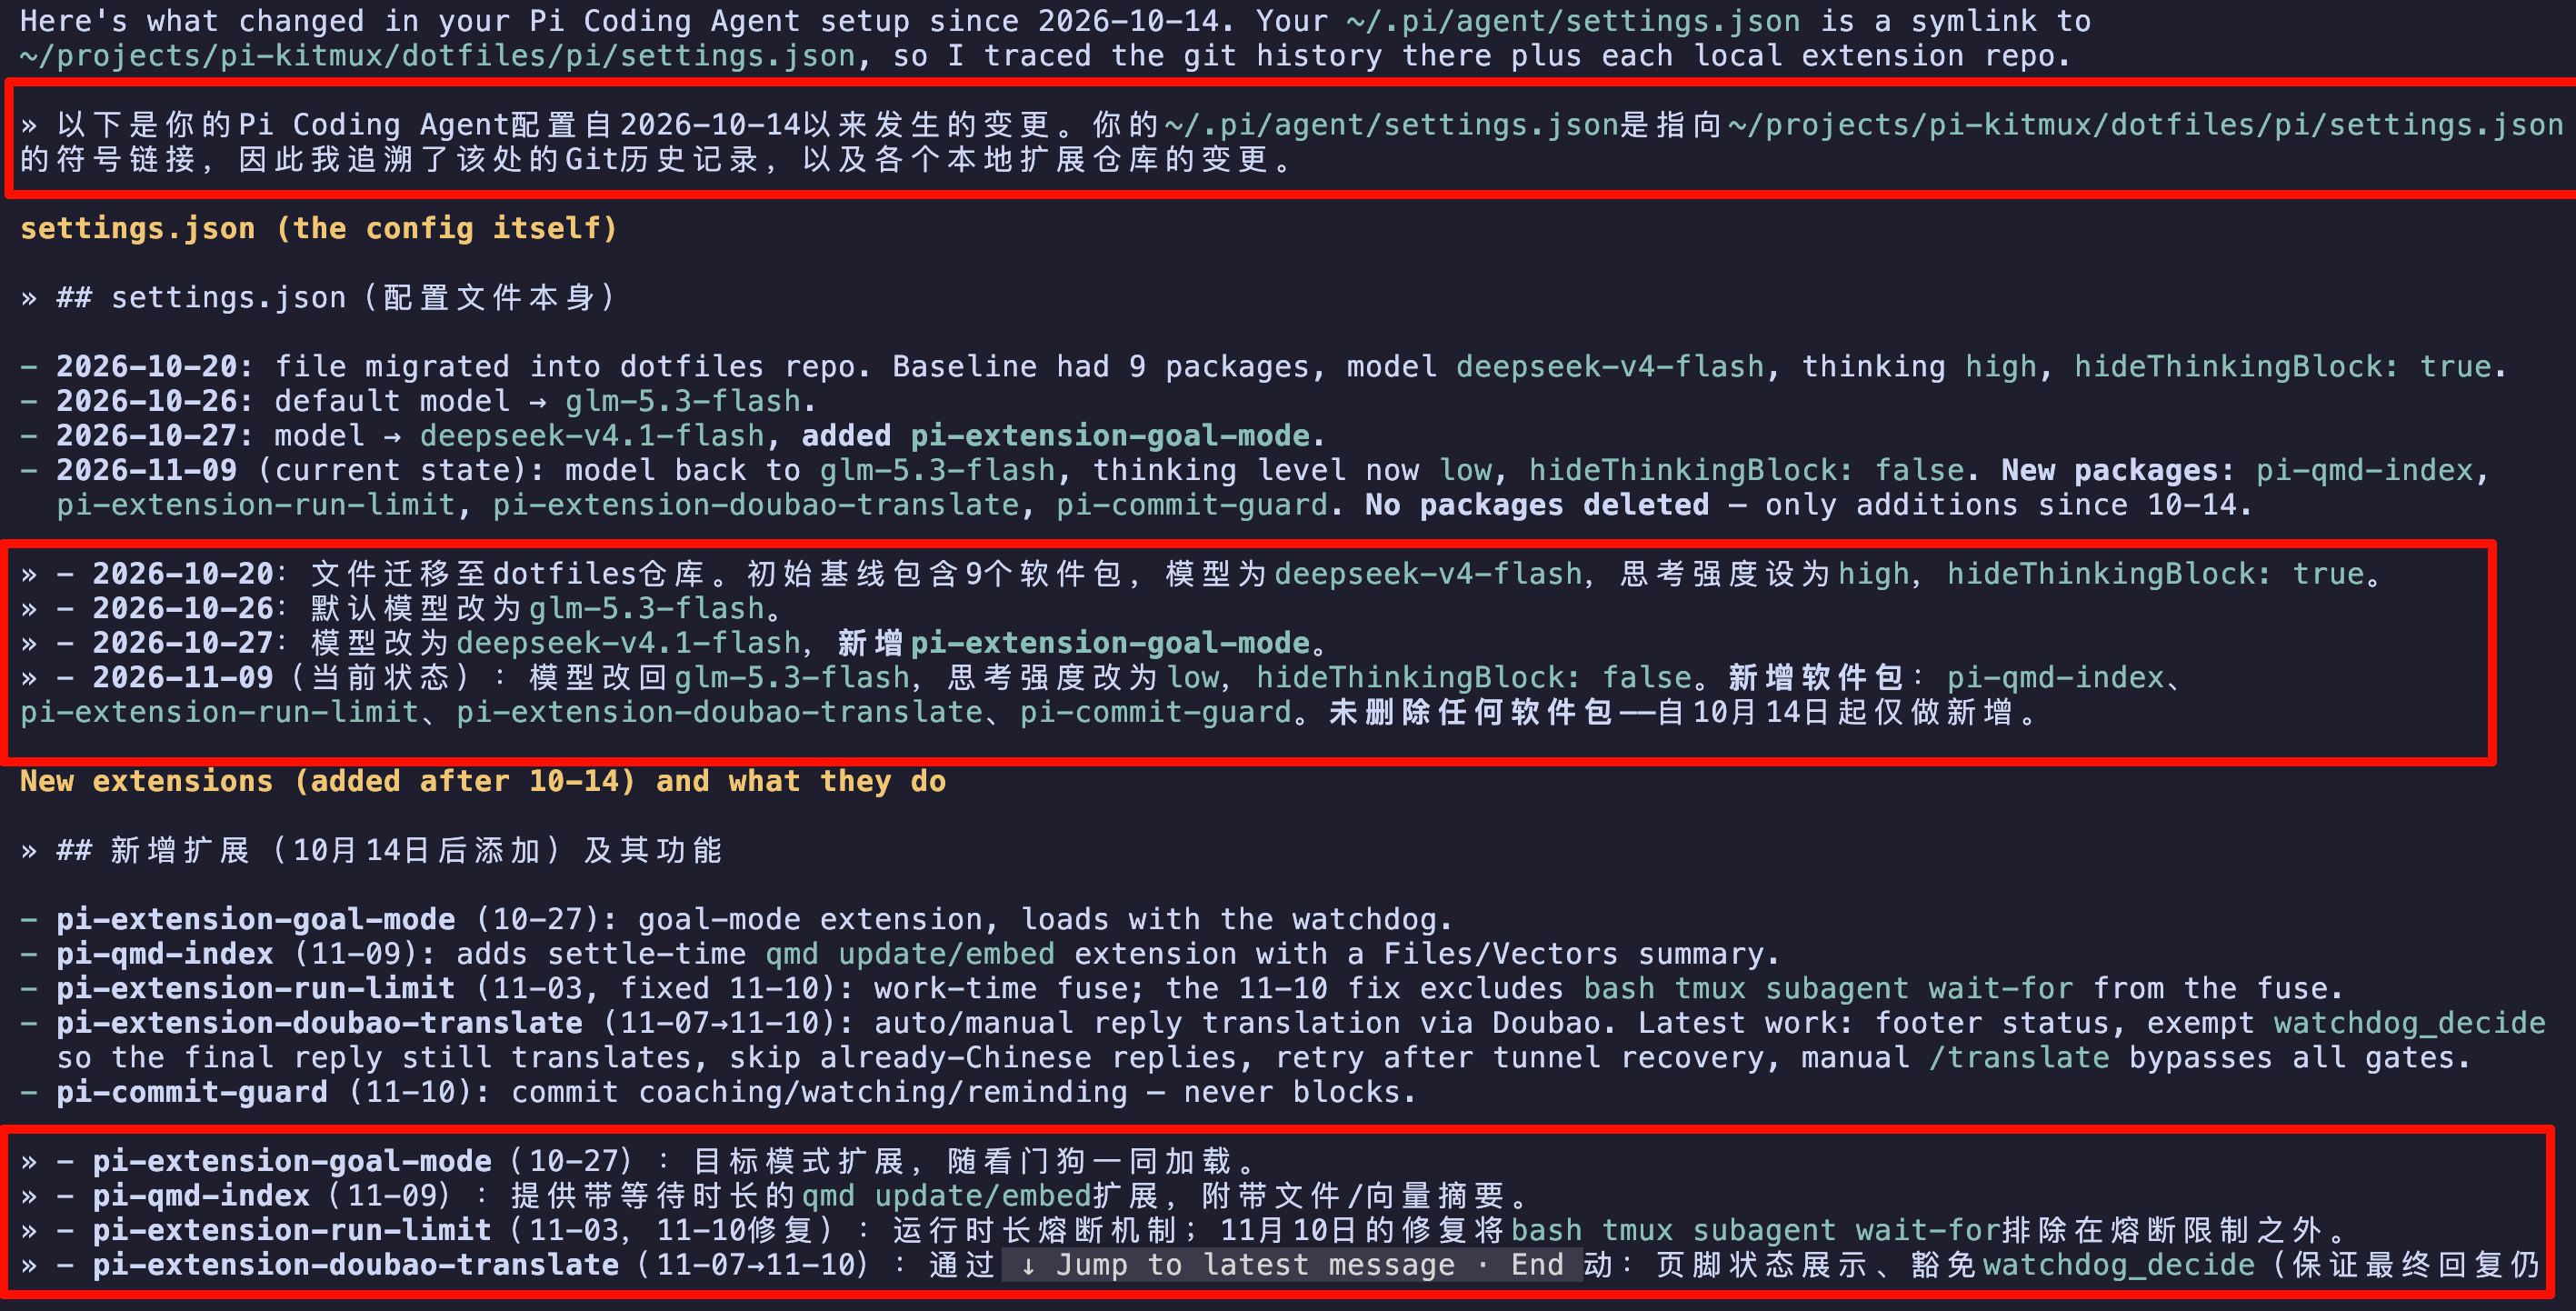
有时候模型降智了,回复的中文根本不知道是在说什么,即使不降智,像 gpt 这种也是黑话连连,看着脑壳疼,所以我在 system prompt 规范了 ai 回复的语言,让 ai 回复 a2/b1 级别的英文,然后使用插件走豆包 api 双语翻译,目前用着还凑合,如果某些翻译出来的不行,或者是技术术语强行翻译成中文,直接看一眼英文原文的单词就行了。有些时候某些模型不遵守,特别是我现在的 glm-5.3-flash,好在回复的中文不是特别黑话,凑合用着。痛点很痛的话,再看看怎么加强一下这个回复英文的规则。
用豆包而不是 llm 的关键是公益站的模型不稳定,时不时得换翻译模型,而豆包稳定很多 :rofl: 这是我开发了很多 llm 工具/脚本的经验,如果这个功能依赖 llm,而不想付费的话,那么建议不要做,或者是简单实现脚本,然后提供给 agent 调用,让 agent 自己去玩。否则开发出来没有模型或者模型不稳定,没有想用的欲望。
虽然豆包也不是特别讲人话,但是感觉比黑话好多了。更关键的是,豆包这个翻译是零成本,走的豆包 app 自带的划词翻译,具体怎么走,这里就不细嗦了。效果是这样的,插件只会翻译 ai 最后回复的一条消息:
system prompt
这块也添加了一下,感觉之前 Pi Coding Agent 的确实很简洁,如果是没有降智的高级模型,那可能是没有问题。但是我这个是公益站的国模 flash 模型,并且上游可能还降智了。
感知特别明显,前几个月用的时候,不用说明一些规则,也能按照常见的规范使用,现在不行了,莫名其妙会出现一些奇奇怪怪的做法。所以有些东西还是稍微说一下,流程规范一下,效果稍微有一点,但是并不是很多,感觉多了这些提示词,花的 token 也不多,大概 1.3k token,性价比还行。
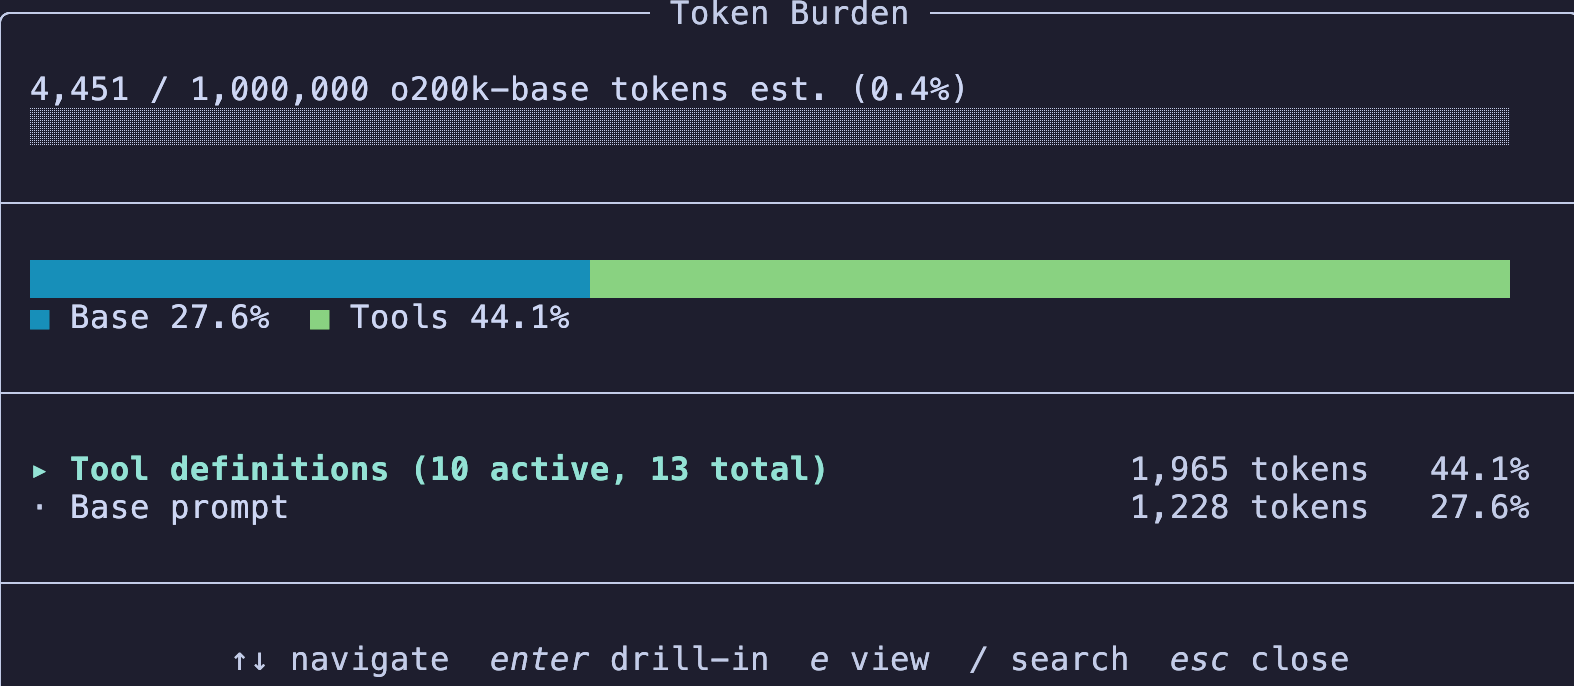
使用 Pi Coding Agent 自带的 --append-system-prompt 命令添加到 system prompt:pi --append-system-prompt /home/jooooody0710/.pi/agent/instructions/main/code.md
1 | # Role & Critical Constraints |
其他
一些不痛不痒的东西也稍微记录一下吧:
- goal 模式很少用,上一轮已经在整了,但是没怎么用,所以还一直是没有完善状态,想用估计都不太用得了。主要是这东西一般是有 token 的时候用,然后挂一晚上,反复探索某个指令。目前我很少有这个需求。
- pi-watchdog:这个插件感觉有点耦合了,现在不好去掉了。因为之前有佬友给我推荐了一个重试插件,我是打算先走重试插件,看看效果,如果重试插件能满足需求,就先用重试插件,pi-watchdog 仅在重试插件没法覆盖的时候使用。后续感觉这一块得稍微梳理一下了,这个插件应该怎么设计比较好,当前有几个插件会和这个插件冲突,都是先相互协调一下处理的方式,没有从设计上根本解决冲突。
- 另外,模型降智后,使用 grill me 这个插件也挺好用的,有时候能自己触发,有时候不能,如果需要也可以自己触发一下。我是把触发规则写在了 system prompt,然后叫 ai 主动去读取那个 grill 的规则文件。文件放在了 prompts 下面,所以也可以使用 slash 命令来手动触发。
- 有一些插件可以实现自进化功能,特别是需要根据历史对话数据决定阈值的,增加个命令还是什么的,然后一调用 ai 就会自动分析历史对话数据,然后重新确认最合适的阈值。因为随着历史对话数据越来越多,阈值也得跟着修改到合适的数值。我一般是手动触发,直接执行一个slash 命令就行了,比如
/bash-guard audit,然后就会自己跑了,接着我等着看结果确认就好了。 - advisor subagent 模式改为直接 fork 主 agent 的上下文,并且只读不能调用工具,一轮返回审核的结果。之前上下文传递是使用 pi-vcc 压缩上下文 + 模型给的 context,然后 advisor 可以多轮执行,用多了发现 advisor 一直在那里探索,很多时候消耗的 token 比直接 fork 全部上下文一轮回答还大,所以现在改为这种方式再实验一下。