两个单元测试入门Pi coding agent基本设计
前言
可以从单元测试开始理解 pi coding agent 的设计,一是可以直接运行看是什么情况,二是提供了一个调用场景方便看是怎么使用的,三个可以修改代码,添加一下日志打印,查看想要追踪的值的变化。虽然某些部分可能和正式运行的时候不一样,但是先从简单的流程开始,后面再慢慢替换掉不同的地方,这样可以更好的了解整体部分的设计。
学习的代码仓库:https://github.com/earendil-works/pi,分支是 main,最新一次提交是 b79e4cc834970cca69daebffab7df1da7d1e52c4,日期是 2026 年 8 月 28 日,正好是 0.84.4 版本的 release。
因为我自己可能添加了一些调试方法,可能截图里面的代码行数和实际对不上,但是主体代码行为没有做任何修改。
用例一:发送一句话和接收一句话
从packages/agent/test/agent-loop.test.ts的agentLoop with AgentMessage中的should emit events with AgentMessage types用例看起,LLM 和 Agent 的交互只有两句话,Agent 发一句,LLM 回复一句就结束,没有工具调用,最基本的使用用法,很适合打基础。
代码实现上采用了生产者消费者架构,两者的通信采用了内存队列的方式:
- 生产者是 pi coding agent,负责启动 agent,会在关键节点会往队列里面放入事件。
- 消费者则是测试用例,会从队列里面拿出所有事件,然后断言事件行为的准确性。
- 队列则是 pi coding agent 自己封装的,实现了
AsyncIterable接口,向外暴露了 AsyncIterator、push、end、result等方法,用于遍历,往队列里面放数值,结束队列,拿最终汇总的结果等。
消费者
- streamFn:因为这里是单元测试,肯定不会真的发送,所以是通过 mock 的形式,模拟一下 LLM 的返回内容就行,所以这里模型的配置信息先不用关注。
- 模拟的方法则是通过提供一个
streamFn函数,使用queueMicrotask推事件,模拟请求的异步操作,agent 会在适当的时候从这里取到 mock 的内容,然后继续后面的处理流程。 - 反过来想,如果是真的请求,那么自然不是这样实现,会是真的发送内容给 LLM,然后把真实返回放到
AssistantStream里面。 - 这里也可以知道为什么要把
streamFn拆开了,等于是把 response stream 的产生解耦了,达到可以 mock,也可以正常发送逻辑的效果。
- 模拟的方法则是通过提供一个
- agentLoop:核心代码逻辑,管理一轮对话的完整生命周期,向外输出事件流
- 返回 stream ,然后测试用例通过 for await 从 stream 取事件,也可以理解为内存队列。
1 | describe("agentLoop with AgentMessage", () => { |
生产者
- agentLoop:入口从
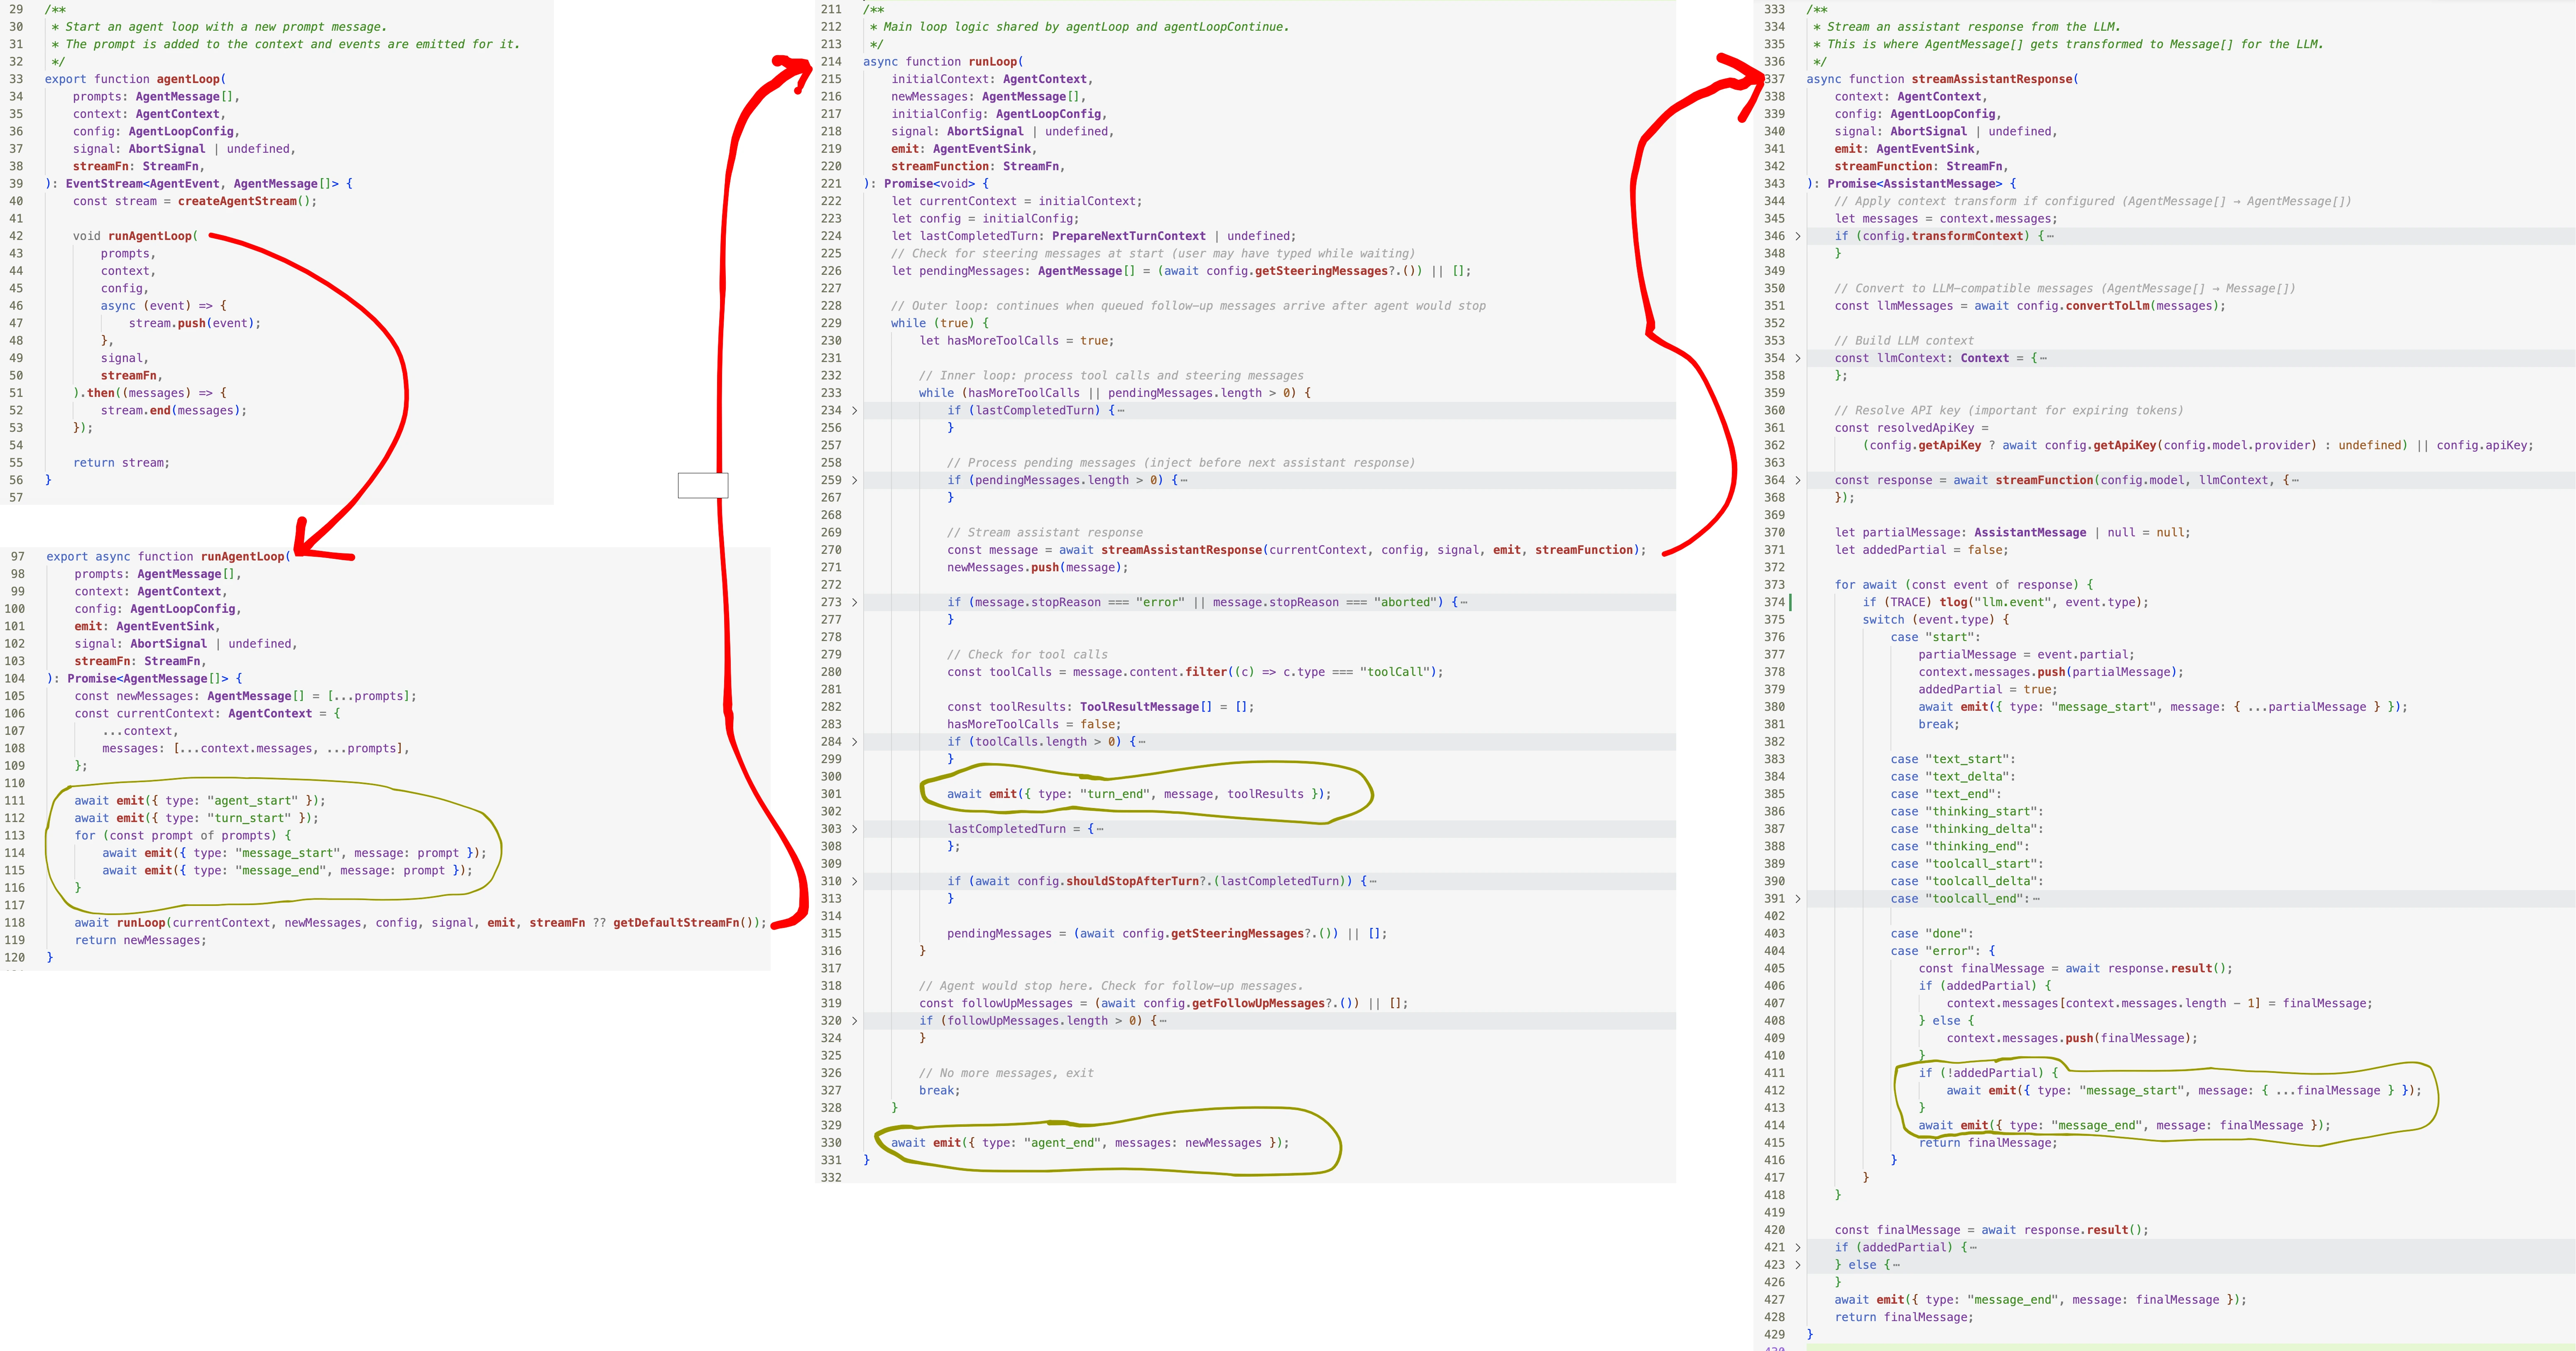
agentLoop开始,先是创建了个 stream 返回给消费者,并且开启一个异步runAgentLoop任务, - runAgentLoop:
runAgentLoop会向 stream pushagent_start、turn_start、message_start、message_end四个事件,并异步执行runLoop。 - streamAssistantResponse:
runLoop的streamAssistantResponse会从streamFn中取到 mock 返回的消息,并且根据返回的done事件,向 stream pushmessage_start、message_end事件。 - runLoop:最终
streamAssistantResponse执行完成,runLoop继续执行,接着向 stream 先后 push 了turn_end和agent_end事件,代表这次对话到此结束。
那么最终的事件流就是:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32agent_start
↓
turn_start
↓
message_start:user
↓
message_end:user
↓
message_start:assistant
↓
message_end:assistant
↓
turn_end
↓
agent_end
---
可以看成:
Agent
│
└── Turn
│
├── Message (user)
│ ├── message_start
│ └── message_end
│
└── Message (assistant)
├── message_start
└── message_end
---
上图中的是user和assistant指的用户发送的文本和 LLM 返回的内容:1
2User: "Hello"
Assistant: "Hi there!"
Event Loop
在实现的过程中用了很多 promise(async/await),并且都是直接返回一个 stream,然后异步去执行更多操作,等于是先把 stream 返回,然后再异步往里面填充内容。
js 调度的机制 event loop 决定了生产者和消费者什么时候执行:
从整体上看是这样的:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20Producer
│
├── push(agent_start)
│
├── push(turn_start)
│
└── push(message_start:user)
↓
Stream
↓
Consumer
│
├── get(agent_start)
├── get(turn_start)
├── get(message_start:user)
└── ...
但是在 js runtime 实际的情况是:1
2
3
4
5
6
7
8
9Producer 暂停
↓
Consumer 有机会运行
↓
Consumer 暂停
↓
Producer 有机会继续
↓
...
也就是生产和消费不是一一对应的,这段代码在 js 的机制下,更多是生产的速率领先于消费,输出的顺序可以参考:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39AGENT_LOOP_TRACE=1 node node_modules/vitest/dist/cli.js --run packages/agent/test/agent-loop.test.ts -t "should emit events with AgentMessage types" --config packages/agent/vitest.config.ts --silent=false
RUN v4.1.9 /Users/jooooody/Projects/pi
[0001] 170.11ms stream.push agent_start
[0002] 170.45ms consumer.next await
[0003] 170.49ms stream.push turn_start
[0004] 170.59ms stream.push message_start:user
[0005] 170.60ms consumer.next agent_start
[0006] 170.61ms stream.push message_end:user
[0007] 170.62ms consumer.next await
[0008] 170.81ms consumer.next turn_start
[0009] 170.88ms consumer.next await
[0010] 170.99ms consumer.next message_start:user
[0011] 171.02ms llm.event done
[0012] 171.04ms consumer.next await
...
[0026] 171.34ms consumer.next agent_end:2
[0027] 171.36ms consumer.next await
[0028] 171.39ms consumer.next DONE
[0029] 171.42ms result.await
[0030] 171.44ms result.done 2 msg
-·---------------------
Test Files 1 passed (1)
Tests 1 passed | 22 skipped (23)
Start at 14:12:31
Duration 593ms (transform 227ms, setup 0ms, import 503ms, tests 4ms, environment 0ms)
用例二:一次工具调用
同测试集下的should handle tool calls and results用例,对比用例一添加了 tool call。真实的 agent tool call 循环是:LLM 回复 → 有 tool call 就执行 → 把结果给回 LLM → 直到 LLM 给出纯文本回复。
但是这个用例只是实现了一次工具调用,没有连续调用,不过也无妨,渐入学习也不错。
工具的定义
仅介绍用例用到的,可能有些参数没有使用上,这里没有列出来。
- name: 工具名,LLM 调用的时候根据名字知道是调用哪个工具
- label:在 UI 上展示的名字,仅仅是 agent 内部用的,LLM 不可见
- description:给 LLM 描述用途
- parameters:工具的参数,用 TypeBox 定义的,这里的意思是需要一个 string 类型的 value
- execute:这个工具执行的逻辑,需要实现的效果
- content:回传给 LLM 的文本/图片内容
- details:在 UI 上展示的,仅仅是 agent 内部用的,LLM 不可见
- usage:执行工具后的一些统计信息
1 | const toolSchema = Type.Object({ value: Type.String() }); |
从代码也可以知道,用例定义了一个名字叫echo的工具,这个工具的逻辑仅仅是往 executed 里面 push 了调用工具时传入的参数的值,然后就返回echoed: ${params.value}的文本内容了。executed 是给测试用例断言用的,所以这个工具的逻辑就是跟名字一样,返回传入的参数值。
工具的传递
定义了一个工具,怎么传给 agent 和 LLM 呢?也就是说,LLM 怎么知道有哪些工具,或者是当 LLM 返回需要调用的工具的名字时候,agent 去哪里找到这个工具?
有一个叫做AgentContext的东西,里面有三个字段,其中一个字段就是 tools,定义的工具都存放在里面。
1 | const context: AgentContext = { |
这个 context 会贯穿整个流程,所以当发送请求给 LLM 的时候,会从 context 中取出所有工具定义,然后序列化发送给 LLM,例如 openai-responses 接口的请求体:
(tools.parameters.type 是 object,只说明参数必须是一个 JSON 对象,这是 schema 的根节点声明,真正参数类型看 properties)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38{
"model": "gpt-5-mini",
"input": [
{
"role": "developer",
"content": "sys"
},
{
"role": "user",
"content": [
{
"type": "input_text",
"text": "hi"
}
]
}
],
"stream": true,
"store": false,
"tools": [
{
"type": "function",
"name": "echo",
"description": "Echo tool",
"parameters": {
"type": "object",
"required": [
"value"
],
"properties": {
"value": {
"type": "string"
}
}
}
}
]
}
想要在 pi coding agent 源码里面查看请求体,可以使用packages/ai/test/openai-responses-compat.test.ts的omits reasoning when no reasoning is requested这个用例,只需要在用例里面的 context 加上 tools 的定义就好了,然后在 onPayload 的 hook 方法里面打印一下请求体就好了:1
2
3
4onPayload: (payload) => {
console.log("payload:", JSON.stringify(payload, null, 2))
capturedPayload = payload;
},
那么 LLM 需要调用某个工具的时候,返回的格式是怎么样的?会在返回的 content 和 stopReason 字段中带上对应的信息,比如:1
2
3
4
5
6
7
8
9
10
11{
"content": [{
"type": "toolCall",
"id": "tool-1",
"name": "echo",
"arguments": {
"value": "hello"
}
}],
"stopReason": "toolUse"
}
实际上也就对应测试用例里面的 streamFn 的 message:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20let callIndex = 0;
const streamFn = () => {
const stream = new MockAssistantStream();
queueMicrotask(() => {
if (callIndex === 0) {
// First call: return tool call
const message = createAssistantMessage(
[{ type: "toolCall", id: "tool-1", name: "echo", arguments: { value: "hello" } }],
"toolUse",
);
stream.push({ type: "done", reason: "toolUse", message });
} else {
// Second call: return final response
const message = createAssistantMessage([{ type: "text", text: "done" }]);
stream.push({ type: "done", reason: "stop", message });
}
callIndex++;
});
return stream;
};
LLM 返回需要调用的工具后,agent 是怎么查找和执行的?1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17async function prepareToolCall(
currentContext: AgentContext,
assistantMessage: AssistantMessage,
toolCall: AgentToolCall,
config: AgentLoopConfig,
signal: AbortSignal | undefined,
): Promise<PreparedToolCall | ImmediateToolCallOutcome> {
const tool = currentContext.tools?.find((t) => t.name === toolCall.name);
if (!tool) {
return {
kind: "immediate",
result: createErrorToolResult(`Tool ${toolCall.name} not found`),
isError: true,
};
}
...
}
其实就是在 context 里面根据工具的名字找,如果找不到就生成错误的结果,然后返回给 LLM 自行纠正。至于执行工具逻辑的话,那么就是直接取出execute,然后执行execute这个函数就行了。
(这里只讲关键步骤,省了很多东西,比如执行前的参数校验,同步执行还是异步执行,执行前后的hook函数等。)
整个事件流
这个树形对比用例一的详细了点,如果是 stream 里面的事件,会用[]包括起来,例如[turn_start],像Turn 1这种仅仅是标识作用,实际代码里面没有发这个事件。
1 | Agent |